 Desenvolvimento
SQL - ANSI
Conceito de modelo relacional
O modelo relacional foi descrito pela primeira vez pelo matemático E. F. Codd, em um artigo de junho de 1970 entitulado "A Relational Model of Data for Large Shared Data Banks" ("Um Modelo Relacional de Dados para Grandes Bancos de Dados"). Naquela época, os modelos mais utilizados no projeto de banco de dados eram os modelos hieráquicos, de rede e estruturas de dados de arquivos planos. Estes primeiros modelos apresentavam muita complexidade na manipulação e exigiam um alto grau de manutenção das aplicações. O modelo relacional foi tão amplamente aceito no mercado, que proporcionou o advento dos programas chamados sistemas de gerenciamento de banco de dados relacionais, ou RDBMS. Conceitualmente um RDBMS é um programa que tem como finalidade oferecer serviços relacionados ao acesso e ao armazenamento de dados. Para efetuar consultas e manipulação de dados em um banco de dados relacional, não é preciso especificar o mecanismo de acesso às tabelas, e muito menos saber como os dados são organizados fisicamente. Essas tarefas são realizadas pelo RDBMS. Os RDBMSs tornaram bastante populares pelas seguintes vantagens : flexibilidade : facilidade na definição da estrutura de armazenamento e na manipulação de dados. independência entre dados e programas : nos antigos sistemas, cada programa precisava ter rotinas de definição dos arquivos físicos e algoritmos de acesso aos arquivos. Isto gerava um enorme custo de manutenção de software. Os atuais RDBMSs executam estas tarefas e o programador preocupa apenas com a solicitação e manipulação dos dados. integridade de dados : a redundância era um dos grandes problemas encontrados nos antigos sistemas de processamento de arquivos. Um mesmo campo ou registro de dados se propagava em mais de um arquivo em mais de um sistema e as informações tornavam-se inconsistentes. Tendo por vantagem um embasamento matemático, o modelo relacional proporciona a prec Como vemos na tabela abaixo, o modelo relacional consiste em uma coleção de objetos, chamados de relações, que tem como objetivo armazenar os dados. Como o modelo relacional foi concebido matematicamente através da álgebra relacional, existe também no modelo um conjunto de operadores que atuam sobre as relações, com o objetivo de produzir outras relações.isão e consistência dos dados, eliminando a redundância. COD_DEP NOME_DEP 01 Matemática 02 Computação 03 Engenharia Civil 04 Direito
Terminologia do banco de dados relacional
Em um modelo relacional existem alguns termos importantes, que são muito utilizados pelos projetistas de banco de dados : Relação (ou tabela) Uma relação (ou tabela) é uma estrutura para o armazenamento de dados no RDBMS. Uma tabela é formada por uma ou mais colunas e zero ou mais linhas. A tabela é equivalente ao conceito de entidade no modelo entidade-relacionamento. Linha (ou tupla) Uma linha é equivalente ao conceito de registro de um arquivo, ou seja, é uma combinação de valores que representa a ocorrência de uma entidade. Por exemplo, o conjunto de informações sobre uma determinada disciplina na tabela de disciplinas. Coluna Uma coluna representa um determinado atributo de uma tabela. ÿ similar ao conceito de campo de um arquivo. Uma coluna é limitada por um domínio, ou seja, o conjunto de valores que poderá assumir. Por exemplo : Nome do campo : CODIGO_DISCIPLINA Tipo de Dados : Númerico Tamanho : 6 posições Domínio : CODIGO_DISCIPLINA Z + (números inteiros) Célula (ou campo) Uma célula é uma unidade de informação atômica, isto é, possui somente um único valor associado. A célula é a interseção de uma linha com uma coluna da tabela. Se não houver dado na célula, ela possui um valor nulo. Nulo, no modelo relacional, significa ausência de valor. Chave Primária (Primary Key ? PK) A chave primária é essencial no modelo relacional. Para cada tabela em um modelo relacional deve existir uma chave primária correspondente. Uma chave primária identifica de forma exclusiva uma linha da tabela. Em outras palavras, dado um valor de chave primária para uma tabela, existe uma e apenas uma linha correspondente nesta tabela. Uma chave primária, é composta de uma coluna (chave primária simples) ou uma combinação de colunas (chave primária composta). Uma chave primária é formada pelos atributos identificadores de uma entidade no modelo entidade-relacionamento. Em geral, as chaves primárias não podem ser alteradas. Por exemplo, vemos na figura 2 que COD_DISC é chave primária da tabela de disciplina. Nenhuma outra coluna poderia identificar de forma exclusiva uma disciplina.
Chave Estrangeira (Foreign Key ? FK) Uma chave estrangeira é uma coluna ou conjunto de colunas referente a uma chave primária da mesma ou de outra tabela, ou seja, seu valor deve coincidir com um valor de chave primária existente. Esta equivalência entre chave estrangeira e chave primária permite a relacionamento entre as tabelas, permitindo a associação entre as linhas das tabelas. As chaves estrangeiras são criadas para reforçar as regras do projeto do banco de dados relacional. Por exemplo, a coluna COD_DEP é chave primária da tabela de DEPARTAMENTO, pois identifica exclusivamente os dados de um determinado departamento. Com o objetivo de estabelecer o relacionamento, COD_DEP também é chave estrangeira na tabela DISCIPLINA, e com isto permitindo a associação entre uma linha da tabela de DEPARTAMENTO e outra na tabela DISCIPLINA. As chaves primárias e suas respectivas chaves estrangeiras precisam compartilhar as mesmas características lógicas e físicas, tais como domínio, tipo de dados e tamanho. Uma observação importante é que as chaves estrangeiras são ponteiros lógicos, não físicos. Na figura abaixo, demonstramos todos os termos utilizados no modelo relacional :
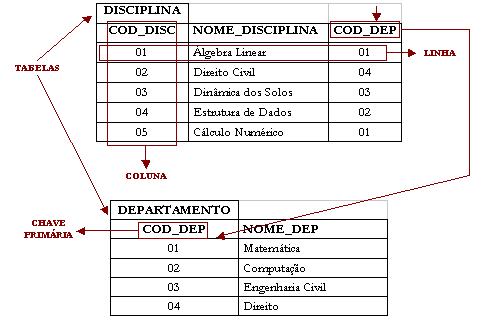
Restrições de integridade de dados
O modelo relacional utiliza regras de integridade na criação das tabelas de forma a oferecer consistência do banco de dados. Embora a integridade de dados pode ser oferecida no nível de programação, os projetistas aplicam estas restrições no nível do banco de dados, exigindo menor esforço na programação das aplicações. Existem quatro tipos de restrições de integridade, a saber : Restrição de entidade A restrição de entidade declara que nenhum valor de nenhum campo da chave primária pode ser nulo ou NULL.
Restrição de integridade referencial
Declara que para um dado valor de uma chave estrangeira sempre existe um valor equivalente de chave primária na tabela referenciada. Por exemplo, quando adicionamos uma linha a uma tabela contendo uma chave estrangeira, a tabela contendo a chave primária referenciada precisa ter um valor equivalente. Além disso, quando uma tabela contendo uma chave primária referencia uma tabela com uma chave estrageira equivalente, os valores da chave primária não podem ser alterados e/ou apagados, sob pena de causar chaves estrangeiras órfãs, destruindo a integridade referencial. Este problema pode ser resolvido permitindo o uso de operações de alteração e exclusão em cascata (cascade) : na alteração em cascata, se os valores da chave primária se alteram, os respectivos valores das chaves estrangeiras são alterados. Na exclusão em cascata, se uma chave primária for excluída, as linhas das tabelas contendo as chaves estrangeiras referenciadas por aquela chave primária são também excluídas.
Restrição de coluna (Domínio)'
A integridade de coluna garante que valores nas colunas de uma relação são restritos às definições dos seus domínios lógicos e físicos. Estas descrições de domínio são definidas na aplicação. Por exemplo, o domínio do campo COD_ALUNO pode ser : Físico : tipo de dados "numeric"; comprimento "4 caracteres" Lógico : "a faixa de números inteiros entre 1000 e 4999" Portanto, o campo somente permitiria a entrada de números de quatro dígitos entre 1000 e 4999. Restrição definida pelo usuário Os usuários podem definir regras de integridade de acordo com a política adotada pelo negócio. Por exemplo, o fato de que "um estudante pode ser matriculado entre janeiro e fevereiro do corrente ano" é uma restrição comum observada no modelo de um sistema acadêmico. O PostGreSQL permite a declaração de restrições definidas pelo usuário.
Nomenclatura dos Objetos Objetos do Banco Oracle utilizados pelo Totali 2000
Prefixo Descrição / (Conjunto) Formato Formação TT Totali Table (user_tables) TT_nnn nnn = Codificação que identifica a tabela. Ex.: TT_VEM = Tabela de Vendas TD Totali Domínio (user_tables) TD_nnn nnn = Codificação que identifica uma tabela do tipo domínio. Ex.: TD_FIL = Tabela de Domínios de Filiais TW Totali Work (user_tables) TW_nnn nnn = Codificação que identifica uma tabela do tipo ?work?, ou seja, para trabalhos temporários Ex.: TW_VEM = Tabela temporária de Vendas TL Totali Log (user_tables) TL_nnn nnn = Codificação que identifica a tabela do tipo ?Log?, ou seja, que mantém alterações feitas na
tabela ?pai?. Ex.: TL_CLI = Tabela de LOG de alterações em Clientes. TR Totali Resumo (user_tables) TR_nnn nnn = Codificação que identifica a tabela do tipo ?Resumo?, ou seja, que mantém dados totalizados
de outras tabelas. Ex.: TR_MOV = Tabela de Resumos de Movimentação de Estoque. Resumo da View TV_MOV. TP Totali Personal (user_tables) TP_nnn nnn = Codificação que identifica a tabela do tipo ?Personal?, ou seja, que mantém colunas
personalizadas pela empresa. TM Totali Manutenção (user_tables) TM_nnn nnn = Codificação que identifica a tabela do tipo ?Manutenção?, ou seja, tabelas para registrar
operações de mudança de códigos primários, utilizadas pelo Totali Tools. TV Totali View (user_views) TV_nnn nnn = Codificação que identifica a view. Ex.: TV_RES = Restrições de Clientes CUIDADO: Uma view pode fazer inúmeros acessos e cálculos internos, e muitas vezes foram projetas para serem executadas somente para um único identificador. Por exemplo, a TV_RES foi projetada para buscar as restrições de um único CGC/CPF (NUMDOC) e deve ser executada utilizando uma cláusula WHERE. A execução de views como esta para todo o conjunto de dados pode ocasionar em pesquisas extremamente lentas. TG Trigger (user_triggers) TGxnnn x = Tipo de tabela a qual a trigger está relacionada. Pode ser D para prefixo TD, W para TW, L para TL e R para TR. O prefixo TT não utiliza esta posição de tipo. nnn = Codificação que identifica a tabela a qual a trigger está relacionada. Ex.1: TGVEN = Trigger para a tabela de Vendas Ex.2: TGWVEN = Trigger para a tabela temporária de vendas SQ Sequenciadores (user_sequences) SQxnnn x = Tipo de tabela a qual o sequenciador está relacionado. Segue a mesma regra utilizada nas
triggers. Nnn = Codificação que identifica a tabela a qual o sequenciador está relacionado. Ex.1: SQVEN = Sequenciador para a tabela de Vendas. Ex.2: SQLCLI = Sequenciador para a tabela de Log de Clientes. PK Primary Key (user_constraints ou user_indexes) PK_xnnn x = Tipo de tabela a qual o chave primária está relacionada. Segue a mesma regra utilizada nas
triggers. nnn = Codificação que identifica a tabela a qual o chave primária está relacionada. Ex.1: PK_VEN = Primary Key para a tabela de Vendas. Ex.2: PK_WVEN = Primary Key para a tabela temporária de Vendas. AK Alternate Key (user_constraints ou user_indexes) AK_xnnn_id x = Tipo de tabela a qual o chave alternativa está relacionada. Segue a mesma regra utilizada nas
triggers. nnn = Codificação que identifica a tabela a qual o chave alternativa está relacionada. id = Identificador. Pode ser formado por um código de tabela (Vide Ex.1), por um nome de coluna
(Vide Ex.2), ou por um nome lógico (Vide Ex.3). Ex.1: AK_ICT_GRA_CTT = Alternate Key para a tabela de Itens de Contrato, sendo identificado como
estrutura única a primary key de Grade e Contrato. Ex.2: AK_GRA_REFPRO = Alternate Key para a tabela de Grade, sendo identificado como estrutura única a coluna REFPRO. Ex.3: AK_VEN_NOTA = Alternate Key para a tabela de Venda, sendo identificado como estrutura única as colunas que identificam uma nota. FK Foreing Key (user_constraint) FK_xooo_yddd x = Tipo de tabela a qual a Foreing Key da tabela origem está relacionada. Segue a mesma regra utilizada nas triggers. ooo = Codificação que identifica a tabela origem a qual a Foreing Key está relacionada. y = idem ?x?, porém para a tabela destino a qual a Foreing Key está relacionada. ddd = Idem ?ooo?, porém para a tabela destino, ou tabela pai. CK Check Constraint (user_constraint) CK_xnnn_coluna x = Tipo de tabela a qual a Check Constraint está relacionada. Segue a mesma regra utilizada nas
triggers. nnn = Codificação que identifica a tabela a qual a Check Constraint está relacionada. coluna = Identifica a coluna da tabela a qual a Check Constraint está relacionada. NN Not Null (user_constraint) NN_xnnn_coluna x = Tipo de tabela a qual a Constraint Not Null está relacionada. Segue a mesma regra utilizada nas triggers. nnn = Codificação que identifica a tabela a qual a Constraint Not Null está relacionada. coluna = Identifica a coluna da tabela a qual a Constraint Not Null está relacionada. I_FK Índice de Foreing Key (user_indexes) I_FK_xooo_yddd A mesma nomenclatura de Foreing Key, alterando o prefixo. I_LC Índice de Localização. (user_indexes) I_LC_xnnn_coluna x = Tipo de tabela a qual o índice está relacionado. Segue a mesma regra utilizada nas triggers. nnn = Codificação que identifica a tabela o índice está relacionado. id = Identificador. Pode ser formado por um código de tabela (Vide Ex.1), por um nome de coluna
(Vide Ex.2), ou por um nome lógico (Vide Ex.3). Ex.1: I_LC_REC_CHR = índice da tabela de recebimentos para localizar Cheques. Não é utilizado I_FK
por ser a integridade procedural. Ex.2: I_LC_REC_PAGAME = Índice para a tabela de Recebimentos para localizar a data de Pagame nto. Ex.3: I_LC_PRO_NOME = Índice para a tabela de Produtos para localizar por NOME (Descrição +
Especificação). I_UQ Índice ÿnico (user_indexes) I UQ_xnnn_id Mesma nomenclatura de AK, substituindo apenas o prefixo. Nota: Índices UQ são utilizados quando as colunas que a compõe podem ser nulas, caso contrário serão sempre AK.
Selecionando dados com comando SELECT O tipo mais comum de comando SQL executado em uma sessão SQLs é uma query ou consulta, construída por um comando SELECT. O comando SELECT tem a função de extrair dados de tabelas do banco de dados. Por exemplo, para retornar todos os registros da tabela de departamentos DEPT, digitamos um comando SELECT no prompt do SQL. Após confirmarmos a entrada do comando, todas as linhas da tabela DEPT são retornadas : SQL> SELECT * FROM DEPT;
ID NAME REGION_ID
10 Finance 1 31 Sales 1 32 Sales 2 41 Operations 1 42 Operations 2 43 Operations 3 50 Administration 1
Note que o usuário não especificou como recuperar os dados, apenas informou quais os dados deveriam ser retornados utilizando a sintaxe do comando SELECT. O seguinte bloco abaixo apresenta uma sintaxe simplificada do comando SELECT : SELECT nome_tabela.nome_coluna, nome_tabela.nome_coluna, ... FROM esquema.nome_tabela ; O primeiro componente apresentado na sintaxe acima é a cláusula SELECT, apenas para identificação do comando SQL fornecido ao PostGreSQL. Em seguida, o usuário especifica uma lista das colunas que gostaria de visualizar. Na declaração fornecida no exemplo anterior a lista de colunas foi substituída pelo caracter especial "asterisco" (*), que indica ao PostGreSQL que o usuário deseja visualizar os dados de todas as colunas da tabela. Para restringir os dados a serem apresentados, o usuário poderia especificar uma lista de colunas. Por exemplo, para apresentar a identificação e o nome de todos os departamentos na tabela DEPT : SQL> SELECT ID, NAME FROM DEPT;
ID NAME
10 Finance 31 Sales 35 Sales 41 Operations 42 Operations 43 Operations 50 Administration
Um outro componente fundamental em um comando SELECT é a cláusula FROM. Esta cláusula especial refere-se a tabela que será acessada pelo PostGreSQL para retornar a lista de colunas especificada pelo usuário. Em algumas situações, o usuário necessitará especificar antes do nome da tabela o nome do esquema, ou seja, o nome do proprietário o qual a tabela pertence. SQL> SELECT ID, NAME FROM PUBLIC.REGION; ID NAME
--------------------------------------------------
1 North America 2 South America 3 Africa / Middle East 4 Asia 5 Europe Observe no comando SELECT fornecido que o nome especificado para a tabela é PUBLIC.REGION. Isto significa que o PostGreSQL buscará os dados na tabela REGION no esquema PUBLIC. Quando um usuário possui autorização para criação de objetos no banco de dados, estes objetos são apropriados pelo seu usuário. O agrupamento lógico dos objetos do banco de dados apropriados por um determinado usuário constitui o seu esquema.
Efetuando Operações Aritméticas
Além da simples seleção de dados de uma tabela, o PostGreSQL permite a realização de cálculos aritméticos sobre as colunas. Todas as operações aritméticas básicas são disponíveis em PostGreSQL, conforme os seguintes operadores : Símbolo Operação + Adição - Subtração
Multiplicação / Divisão Por exemplo, para listar a relação de salários de todos os empregados, com um percentual de aumento de 10%: SQL> SELECT ID, LAST_NAME, SALARY, SALARY*1.1 FROM PUBLIC.EMP;
ID LAST_NAME SALARY SALARY*1.1
1 Velasquez 2500 2750 8 Biri 1100 1210 9 Catchpole 1300 1430 10 Havel 1307 1437,7
A linguagem SQL também possibilita a realização de cálculos matemáticos sem a seleção de dados de tabelas. Isto é realizado utilizando uma tabela especial chamada DUAL. A tabela DUAL contém somente uma linha e uma coluna com valor nulo, a fim de possibilitar apenas a realização de operações aritméticas : SQL> SELECT (165.2/8.4)*(982.4/765.2) + 450 FROM DUAL;
(165.2/8.4)*(982.4/765.2)+450
475,249
Manipulando Valores Nulos
Algumas vezes, uma determinada coluna do resultado de uma consulta produzirá ausência de valor para algumas linhas. Para o PostGreSQL, essa ausência de valor é chamado NULL (ou nulo). No projeto de um banco de dados, uma coluna pode ser definida para receber ou não valores NULL. Na consulta abaixo, alguns clientes não possuem telefone : SQL> SELECT NAME, PHONE FROM CUSTOMER; NAME PHONE
---------------
Simms Athletics 81-20101 Delhi Sports Womansport Kam's Sporting Goods 852-3692888 Sportique Sweet Rock Sports 234-6036201 Algumas vezes o usuário exigirá a apresentação de alguma mensagem ou valor caso uma coluna apresente espaços em branco no resultado da consulta. Para isto, utilizamos uma função chamada COALESCE. No exemplo acima, para constar a mensagem "sem telefone" na coluna para os clientes que não possuem telefones, faríamos a seguinte consulta : SQL> SELECT NAME, COALESCE(PHONE, ?sem telefone?) FROM CUSTOMER; NAME PHONE
---------------
Simms Athletics 81-20101 Delhi Sports sem telefone Womansport sem telefone Kam's Sporting Goods 852-3692888 Sportique sem telefone Sweet Rock Sports 234-6036201 Note que, se a coluna especificada em coalesce() não é NULL, o valor naquela coluna é retornado, caso contrário a mensagem definida na função é retornada.
Utilizando Aliases para Colunas
Como você pode ter notado no exemplo anterior, o PostGreSQL cria um cabeçalho especial para cada coluna quando os dados são retornados para o usuário. O nome do cabeçalho corresponde diretamente ao nome ou expressão especificados na lista de colunas do comando SELECT. Como foi utilizada a função coalesce(), a expressão é apresentada no resultado da consulta. Para evitar esta ocorrência, a fim de tornar mais legível o cabeçalho das colunas do resultado, utilizamos o conceito de alias (ou apelido) para a coluna especificada no comando SELECT. Utilizando alias PHONE para substituir a expressão com a função coalesce() no exemplo anterior, teríamos : SQL> SELECT NAME, COALESCE(PHONE, ?sem telefone?) as PHONE FROM CUSTOMER; NAME PHONE
---------------
Simms Athletics 81-20101 Delhi Sports sem telefone Womansport sem telefone Kam's Sporting Goods 852-3692888 Sportique sem telefone Sweet Rock Sports 234-6036201 Para utilizar aliases, utilizamos a seguinte sintaxe : SELECT expressão alias, ...; Ou com a cláusula AS para tornar mais legível : SELECT expressão AS alias, ...;
Concatenando Colunas
Duas colunas podem ser juntadas com o propósito de tornar o resultado mais legível. O método usado para mesclar um conjunto de colunas é chamado de concatenação. A concatenação aplica-se somente a expressões que retornam strings ou cadeias de caracteres. O operador de concatenação são duas barras verticais "||". No exemplo abaixo, criamos uma nova coluna FULL_NAME no resultado a partir da concatenação das colunas LAST_NAME e FIRST_NAME : SQL> SELECT LAST_NAME || ',' || FIRST_NAME FULL_NAME FROM EMP; FULL_NAME
Velasquez,Carmen Ngao,LaDoris Nagayama,Midori Quick-To-See,Mark Ropeburn,Audry
Limitando o Conjunto de Linhas Selecionadas
De acordo com a necessidade dos usuários, as aplicações de banco de dados muitas vezes precisam selecionar um conjunto de linhas de um tabela. Estudaremos agora as técnicas para definir consultas que ordenam e limitam conjuntos de linhas de uma tabela. A Cláusula ORDER BY Em nosso exemplo da tabela EMP a seguir, verificamos um princípio adotado em banco de dados relacional. ÿ o princípio de que os dados não precisam ser armazenados em ordem. SQL> SELECT * FROM EMP; ID LAST_NAME FIRST_NAME SALARY
-------------------- -------------------- ---------
10 Havel Marta 1307 2 Ngao LaDoris 1450 9 Catchpole Antoinette 1300 6 Urguhart Molly 1200 O PostGreSQL permite ao usuário ordernar uma consulta através da cláusula ORDER BY do comando SELECT. Esta cláusula é colocada no final da declaração do comando, de acordo com a seguinte sintaxe : SELECT expr FROM table [ORDER BY {column, expr} [ASC | DESC] ]; onde : ORDER BY ? especifica a ordem no qual as linhas retornadas são exibidas column, expr ? lista das colunas a serem ordenadas ASC ? ordena as linhas em ordem ascendente. Essa é a ordem default DESC ? ordena as linhas em ordem descendente Por exemplo, para fazermos uma relação de nomes e salários dos funcionários ordenada pelo sobrenome do funcionário, faríamos a seguinte consulta : SQL> / ID LAST_NAME FIRST_NAME SALARY
-------------------- -------------------- ---------
8 Biri Ben 1100 9 Catchpole Antoinette 1300 22 Chang Eddie 800 10 Havel Marta 1307 16 Maduro Elena 1400 Para revertermos a ordem na qual as linhas são exibidas, utilizamos a palavra DESC especificada após o nome da coluna na cláusula ORDER BY. Por exemplo, para apresentar a relação de funcionários ordenada pela data mais recente de admissão :
SQL> SELECT LAST_NAME, DEPT_ID, START_DATE
2 FROM EMP 3 ORDER BY START_DATE DESC;
LAST_NAME DEPT_ID START_DA
--------- --------
Catchpole 44 09/02/92 Maduro 41 07/02/92 Nguyen 34 22/01/92 Giljum 32 18/01/92 Dumas 35 09/10/91 Além dos nomes das colunas, os aliases (apelidos) podem ser usados também na cláusula ORDER BY. Por exemplo, a relação de funcionários ordenada pelo nome completo : SQL> SELECT FIRST_NAME || ' ' || LAST_NAME FULL_NAME
2 FROM EMP 3 ORDER BY FULL_NAME;
FULL_NAME
Akira Nozaki Alexander Markarian Andre Dumas Antoinette Catchpole Audry Ropeburn Bela Dancs Ben Biri Carmen Velasquez A cláusula ORDER BY pode ser aplicada sobre colunas dos tipos NUMERIC, VARCHAR, CHAR e DATE e segue o seguinte critério na ordenação : Os valores numéricos são exibidos a partir dos valores mais baixos, como 1-999. Os valores de data são exibidos começando com a data mais antiga, por exemplo 01-JAN-92 antes de 01-JAN-95. Os valores de caracteres são exibidos em ordem alfabética, como de A a Z. Os valores nulos são exibidos por último em ordem ascendente e em primeiro em ordem descendente. Para evitar redigitação das colunas na cláusula ORDER BY, a ordenação por posição efetua a classificação de acordo com a posição da coluna na lista SELECT. Esta posição é definida através de um número inteiro. No exemplo a seguir, relacionamos todos os departamentos ordenados pela coluna 2 na lista SELECT, neste caso a coluna REGION_ID :
SQL> SELECT NAME, REGION_ID
2 FROM DEPT 3 ORDER BY 2;
NAME REGION_ID
----------
Finance 1 Sales 1 Operations 1 Administration 1 Sales 2 Operations 2 Sales 3 Operations 3 Sales 4 Operations 4 Sales 5 Operations 5 Você pode ordenar os resultados da consulta usando mais de uma coluna. O limite de classificação é o número de colunas na tabela. Na cláusula ORDER BY, especifique as colunas e separe os respectivos nomes usando vírgulas. Se desejar reverter a ordem de uma coluna, especifique DESC após o nome da posição ou coluna. Você pode ordenar de acordo com colunas que não estejam na lista SELECT. Por exemplo, para relacionarmos todos os funcionários ordenados por departamento, e pra cada departamento ordenarmos por salário em ordem decrescente, temos a seguinte consulta : SQL> SELECT DEPT_ID, SALARY, LAST_NAME
2 FROM EMP 3 ORDER BY DEPT_ID, SALARY DESC;
DEPT_ID SALARY LAST_NAME
--------- -------------------------
10 1450 Quick-To-See 31 1400 Nagayama 31 1400 Magee 32 1490 Giljum 33 1515 Sedeghi 34 1525 Nguyen Limitando as linhas selecionadas com a cláusula WHERE A cláusula WHERE é muito importante no comando SELECT, pois permite ao usuário selecionar um conjunto de linhas de centenas, milhares ou milhões delas armazenadas em uma tabela. A cláusula WHERE contém uma condição ou mais condições que devem ser satisfeitas na seleção dos dados. Estas condições operam sobre os princípios básicos de comparação. Vejamos a sintaxe da cláusula WHERE no comando SELECT : SELECT expr FROM table [WHERE condition(s)] [ORDER BY expr]; onde : WHERE ? limita a consulta às linhas que satisfazem uma ou mais condições condition ? uma condição é sempre composta por nomes de colunas, expressões, constantes e operadores de comparação Operadores de comparação Os operadores de comparação são utilizados para formação das condições de uma cláusula WHERE na seguinte sintaxe : ...WHERE expr operator value Os operadores de comparação são apresentados na tabela a seguir : Operador Função x=y Testa se x é igual a y x>y Testa se x é maior do que y x>=y Testa se x é maior ou igual a y x<y Testa se x é menor do que y x<=y Testa se x é menor ou igual a y x<>y x!=y x^=y Testa se x é diferente de y Por exemplo, para selecionarmos a relação de funcionários que ganham acima de $1400,00 inclusive, faremos a seguinte consulta : SQL> SELECT LAST_NAME, DEPT_ID, SALARY
2 FROM EMP 3 WHERE SALARY >= 1400;
LAST_NAME DEPT_ID SALARY
--------- ---------
Velasquez 50 2500 Ngao 41 1450 Nagayama 31 1400 Quick-To-See 10 1450 Ropeburn 50 1550 Os operadores de comparação podem ser utilizados para comparação entre strings de caracteres e datas. Estas devem ficar entre apóstrofos(? ?). A string especificada entre apóstrofo é sensível a letras maiúsculas e minúsculas. Por exemplo, para elaborar uma consulta que mostra o nome, o sobrenome e o cargo do funcionário chamado ?Magee?, devemos fazer :
SQL> SELECT FIRST_NAME, LAST_NAME, TITLE
2 FROM EMP 3 WHERE LAST_NAME = 'Magee';
FIRST_NAME LAST_NAME TITLE
-------------------- ------------------------
Colin Magee Sales Representative Operadores SQL Operador BETWEEN Você pode exibir linhas com base em uma faixa de valores usando o operador BETWEEN. A faixa especificada contém um valor inferior e um superior. Por exemplo, para relacionarmos os nomes e salários dos funcionários com salários entre $1500,00 e $4000,00 inclusive : SQL> SELECT FIRST_NAME, LAST_NAME, SALARY
2 FROM EMP 3 WHERE SALARY BETWEEN 1500 AND 4000;
FIRST_NAME LAST_NAME SALARY
------------------------- ---------
Carmen Velasquez 2500 Audry Ropeburn 1550 Yasmin Sedeghi 1515 Mai Nguyen 1525 Operadores IN e NOT IN O operador IN é utilizado para testar a existência de uma expressão em uma lista de valores. Caso forem usados caracteres ou datas na lista, eles devem vir entre apóstrofos. Por exemplo, para relacionar os nomes dos departamentos das regiões 1,3 e 5 : SQL> SELECT ID, NAME, REGION_ID
2 FROM DEPT 3 WHERE REGION_ID IN (1,3,5);
ID NAME REGION_ID
------------------------- ---------
10 Finance 1 31 Sales 1 45 Operations 5 50 Administration 1 Pode ser utilizado NOT IN para fazer um teste de exceção. Por exemplo, para relacionar todos os departamentos que não pertencem às regiões 1 e 2 : SQL> SELECT ID, NAME, REGION_ID
2 FROM DEPT 3 WHERE REGION_ID NOT IN (1,2);
ID NAME REGION_ID
------------------------- ---------
33 Sales 3 34 Sales 4 35 Sales 5 45 Operations 5
Operadores LIKE e NOT LIKE Em comparações que envolvem strings e textos, nem sempre é possível saber o valor exato a ser pesquisado. Pode-se selecionar linhas que coincidam com um padrão de caracteres, usando o operador LIKE. A operação de combinação com um padrão de caracteres é chamada de pesquisa curinga. Podem ser usados dois símbolos para formar a string de pesquisa : Símbolo Descrição % Representa qualquer seqüência de zero ou mais caracteres - Representa qualquer caracter único Por exemplo, para exibir os sobrenomes de todos os funcionários que começam com a letra "M" : SQL> SELECT LAST_NAME
2 FROM EMP 3 WHERE LAST_NAME LIKE 'M%';
LAST_NAME
Menchu Magee Maduro Markarian O operador NOT LIKE é utilizado para comparar uma expressão e selecioná-la caso não se iguale ao padrão especificado. Por exemplo, para exibir a relação dos sobrenomes de todos os funcionários que não contêm a letra "a" : SQL> SELECT LAST_NAME
2 FROM EMP 3 WHERE LAST_NAME NOT LIKE '%a%';
LAST_NAME
Quick-To-See Ropeburn Menchu Smith Caso o usuário necessite utilizar na comparação os próprios caracteres "%" e "_", deve ser utilizada a opção ESCAPE. Na opção ESCAPE, é identificado o caracter que terá a função de identificar qual símbolo será tratado como caracter. Por exemplo, para exibir o nome das empresas cujos nomes contenham as letras "X_Y" : SQL> SELECT NAME
2 FROM CUSTOMER 3 WHERE NAME LIKE '%X\_Y%' ESCAPE '\';
Operadores IS NULL e IS NOT NULL O operador IS NULL testa valores nulos. Um valor nulo é um valor que está indisponível, não foi atribuído, é desconhecido ou inaplicável. Portanto, você não pode testar com "=", porque um valor nulo não pode ser igual ou desigual a qualquer valor. Por exemplo, para relacionarmos o número, nome e classificação de crédito de todos os clientes que não tem um representante de vendas : SQL> SELECT ID, NAME, CREDIT_RATING
2 FROM CUSTOMER 3 WHERE SALEREP_ID IS NULL;
ID NAME CREDIT_RA
------------------------------------------ ---------
207 Sweet Rock Sports GOOD O operador IS NOT NULL testa valores não-nulos. Por exemplo, para relacionar os sobrenomes, cargos e porcentagem de comissão de todos os funcionários que recebem comissão : SQL> SELECT LAST_NAME, TITLE, COMMISSION_PCT
2 FROM EMP 3 WHERE COMMISSION_PCT IS NOT NULL;
LAST_NAME TITLE COMMISSION_PCT
------------------------- --------------
Magee Sales Representative 10 Giljum Sales Representative 12,5 Sedeghi Sales Representative 10 Nguyen Sales Representative 15 Dumas Sales Representative 17,5 c) Operadores lógicos AND e OR Os operadores lógicos AND e OR podem ser usados quando se precisar especificar mais de um critério de pesquisa na cláusula WHERE do comando SELECT. O operador AND retorna TRUE, se ambas as condições forem TRUE. No exemplo a seguir, a consulta retornará a relação de todos os ajudantes de estoque (primeira condição) do departamento 41 (segunda condição) : SQL> SELECT LAST_NAME, SALARY, DEPT_ID, TITLE
2 FROM EMP 3 WHERE DEPT_ID = 41 4 AND TITLE = 'Stock Clerk';
LAST_NAME SALARY DEPT_ID TITLE
--------- --------- -------------------------
Maduro 1400 41 Stock Clerk Smith 940 41 Stock Clerk O operador OR retorna TRUE, se qualquer uma das condições for TRUE. No exemplo a seguir, são relacionados os funcionários do departamento 41 ou que possuem cargo ajudante de estoque (ou ambas as condições) : SQL> SELECT LAST_NAME, SALARY, DEPT_ID, TITLE
2 FROM EMP 3 WHERE DEPT_ID = 41 4 OR TITLE = 'Stock Clerk';
LAST_NAME SALARY DEPT_ID TITLE
--------- --------- ------------------
Ngao 1450 41 VP, Operations Urguhart 1200 41 Warehouse Manager Maduro 1400 41 Stock Clerk Smith 940 41 Stock Clerk Schwartz 1100 45 Stock Clerk d) Regras de Precedência As expressões lógicas são avaliadas em uma ordem de precedência, ou seja, os operadores são avaliados em uma determinada ordem. As regras de precedência são : Ordem Executada Operador 1 =, <>, <=, >=, [not] IN, [not] LIKE, IS [not] NULL, BETWEEN 2 AND 3 OR O PostGreSQL sempre avalia primeiro as expressões entre parênteses. Quando as expressões forem complexas, o uso de parênteses pode aumentar a clareza do comando. A ordem das expressões e a utilização de parênteses podem modificar a interpretação do comando. Por exemplo, para exibirmos a relação de sobrenome, salário e número de departamento de todos os funcionários do departamento 44 que ganham 1000 ou mais, bem como de todos os funcionários do departamento 42 : SQL> SELECT LAST_NAME, SALARY, DEPT_ID
2 FROM EMP 3 WHERE SALARY >= 1000 4 AND DEPT_ID = 44 5 OR DEPT_ID = 42;
LAST_NAME SALARY DEPT_ID
--------- ---------
Menchu 1250 42 Catchpole 1300 44 Nozaki 1200 42 Patel 795 42 Agora verifique como a colocação dos parênteses altera a interpretação da mesma consulta. A consulta agora retorna a relação de sobrenomes, salários e números de departamento dos funcionários dos departamentos 42 ou 44 que ganham 1000 ou mais : SQL> SELECT LAST_NAME, SALARY, DEPT_ID
2 FROM EMP 3 WHERE SALARY >= 1000 4 AND (DEPT_ID = 42 5 OR DEPT_ID = 44);
LAST_NAME SALARY DEPT_ID
--------- ---------
Menchu 1250 42 Catchpole 1300 44 Nozaki 1200 42
Usando funções SQL para exibição de dados As funções representam um poderoso recurso do SQL e podem ser usadas para : realizar cálculos com dados alterar itens individuais de dados manipular a saída para grupos de linhas alterar formatos de datas para exibição converter tipos de dados de coluna Existem dois tipos distintos de funções : funções de linhas funções de grupo Funções de Linha Estas funções são usadas para manipular itens de dados. Aceitam um ou mais argumentos e retornam um valor para cada linha retornada pela consulta. Um argumento pode ser : Uma constante fornecida pelo usuário Um valor variável Um nome de coluna Uma expressão Recursos das Funções de Linha : Atuam em cada linha retornada na consulta Retornam um resultado por linha Podem retornar um valor de dados de um tipo diferente daquele que foi mencionado Podem esperar um ou mais argumentos do usuário Podem ser aninhadas, ou seja, podem retornar resultados para serem manipulados por outras funções. Podem ser usadas nas cláusulas SELECT, WHERE e ORDER BY. Sintaxe : function_name ( column | expression , [arg1, arg2, ...]) onde : function_name ? nome da função column ? qualquer coluna identificada do banco de dados expression ? é qualquer string de caracteres ou expressão calculada arg1, arg2 ? é qualquer argumento a ser usado pela função As tabelas a seguir apresentam apenas um subconjunto das funções disponíveis no PostGreSQL : Funções de Caracteres Função Finalidade LOWER(column|expression) Converte valores de caracteres alfabéticos em letras minúsculas. Exemplo : LOWER(?Curso SQL?) = ?curso sql? UPPER(column|expression) Converte valores de caracteres alfabéticos em letras maiúsculas. Exemplo : UPPER(?Curso SQL?) = ?CURSO SQL? INITCAP(column|expression) Converte valores de caracteres colocando a inicial de cada palavra em letra maiúscula e os demais caracteres em letras minúsculas. Exemplo : INITCAP(?Curso SQL?) = ?Curso Sql? SUBSTR(column|expression, m[,n]) Retorna caracteres especificados a partir do caracter inicial na posição do caracter m, com extensão de n caracteres. Se m for negativo, a contagem inicia a partir do final do valor de caracteres. Exemplo : SUBSTR(?Curso SQL?, 4, 5) = ?so SQ? LENGTH(column|expression) Retorna o número de caracteres do argumento. Exemplo : LENGTH(?Curso?) = 5 Funções Numéricas Função Finalidade ABS(column|expression) Obtem o valor absoluto para um número. Exemplo : ABS(-1) = 1 CEIL(column|expression) Arredondamento de um inteiro a maior. Exemplo : CEIL(1.6) = 2 CEIL(-1.6) = -1 FLOOR(column|expression) Arredondamento de um inteiro a menor. Exemplo : FLOOR(1.6) = 1 FLOOR(-1.6) = -2 MOD(column1|expression1, column2|expression2) Resto de uma divisão inteira. Exemplo : MOD(10,3) = 1 MOD(10,2) = 0 ROUND(column1|expression1, column2|expression2) Arredondamento de um valor real com uma precisão fornecida como segundo argumento. Exemplo : ROUND(134.345,1) = 134.3 ROUND(134.345, -1) = 130 SIGN(column|expression) Retorna 1 se argumento é positivo e ?1 se argumento é negativo. Exemplo : SIGN(-10) = -1 SQRT(column|expression) Retorna a raiz quadrada do argumento. TRUNC(column1|expression1, column2|expression2) Trunca um valor numérico em uma determinada precisão. Exemplo : TRUNC(982.6528,2) = 982.65 TRUNC(88.21, -1) = 80 VSIZE(column|expression) Tamanho do armazenamento em bytes para o argumento. Exemplo : VSIZE(-1) = 3 VSIZE(1) = 2 GREATEST(column1|expression1, column2| expression2, ...) Retorna o maior valor de uma lista de strings, números, ou datas. LEAST(column1|expression1, column2| expression2, ...) Retorna o menor valor de uma lista de strings, números, ou datas. Funções de Data Função Finalidade MONTHBETWEEN(date1, date2) Retorna um número relativo ao número de meses entre uma data e outra. A parte não inteira do resultado representa a porção do mês. ADD_MONTHS(date, n) Adiciona n meses do calendário à data (n deve ser um número inteiro e pode ser negativo) NEXT_DAY(date, ?char?) Encontra a data do próximo dia da semana especificado (?char?) seguido pela data. char pode ser um número representando um dia ou uma string de caracteres. LAST_DAY(date) Encontra a data do último dia do mês que contenha a data ROUND(date[, ?fmt?]) Encontra a data do primeiro dia do mês contido na data, quando não houver um modelo de formato fmt especificado. Se fmt = YEAR, encontra o primeiro dia do ano que contém a data. ÿ útil para comparar datas que possam ter horários diferentes. TRUNC(date[, ?fmt?]) Retorna a data com a hora ajustada para meia-noite, se não houver um modelo de formato fmt especificado. Essa função é útil para remover parte de hora da data. O PostGreSQL possui uma palavra-chave especial chamada CURRENT_TIMESTAMP, que retorna a data atual. Para verificar a data atual, basta fornecer a seguinte consulta : SQL> SELECT CURRENT_TIMESTAMP FROM DUAL; CURRENT_TIMESTAMP
07/05/99 Funções de Conversão Função Finalidade TO_CHAR(numeric|date[,?fmt?]) Converte um valor numérico ou data para uma string de caracteres VARCHAR com o modelo de formato fmt. TO_NUMERIC(char) Converte uma string de caracteres para um valor numérico TO_DATE(char[,[fmt]) Converte uma string de caracteres representando uma data para um valor do tipo data, de acordo com o formato fmt especificado. Se o fmt for omitido, o formato será DD-MON-YY. Os elementos de formato são úteis na conversão de valores do tipo NUMERIC e DATE para o tipo VARCHAR. Além disso, o uso dos formatos possibilita uma apresentação melhor no resultado de uma conversão de valores. Elementos de Modelo de Formato de Data Elemento Descrição SCC ou CC Século Anos em data YYYY Ano com século YY Ano com dois dígitos RR Ano de acordo com o século atual (substitui o formato YY) YEAR Ano escrito por extenso MM Mês com dois dígitos MONTH Nome do mês MON Abreviação do nome do mês com 3 letras DDD dia do ano DD Dia com dois dígitos DAY Nome do dia da semana DY Nome do dia da semana Por exemplo, para relacionarmos as datas de admissão de todos os funcionários por extenso, utilizamos a função TO_CHAR : SQL> SELECT LAST_NAME,
2 TO_CHAR(START_DATE, 'DD "DE" MONTH "DE" YYYY') DATA_ADMISSAO 3 FROM EMP 4 WHERE START_DATE LIKE '%91';
LAST_NAME DATA_ADMISSAO
-----------------------
Nagayama 17 DE JUNHO DE 1991 Urguhart 18 DE JANEIRO DE 1991 Havel 27 DE FEVEREIRO DE 1991 Markarian 26 DE MAIO DE 1991 Schwartz 09 DE MAIO DE 1991 Elementos de Modelo de Formato de Hora Elemento Descrição AM ou PM Indicador meridiano A.M. ou P.M. Indicador meridiano com pontos HH ou H12 Indicador de hora (1-12) HH24 Indicador de hora (0-23) MI Indicador de minutos (0-59) SS Indicador de segundos (0-59) SSSSS Segundos depois da meia-noite (0-86399) Por exemplo, para apresentarmos a relação dos funcionários com suas respectivas datas e horas de contratação : SQL> SELECT LAST_NAME,
2 TO_CHAR(START_DATE, 'DD/MM/YYYY') DATA_ADMISSAO, 3 TO_CHAR(START_DATE, 'HH:MM:SS') HORA_ADMISSAO 4 FROM EMP 5 ORDER BY LAST_NAME;
LAST_NAME DATA_ADMISSAO HORA_ADMISSAO
--------------- --------------
Biri 07/04/1990 12:04:00 Catchpole 09/02/1992 12:02:00 Chang 30/11/1990 12:11:00 Dancs 17/03/1991 12:03:00 Maduro 07/02/1992 12:02:00 Elementos de Formatos de Números Elemento Descrição Exemplo Resultado 9 Posição numérica (a quantidade de 9s determina a largura da posição) 999999 1234 0 Exibe os zeros à esquerda 099999 001234 $ Sinal flutuante de dólar $999999 $1234 L Símbolo flutuante da moeda L999999 Cr$1234 . Ponto decimal na posição especificada 999999.99 1234.00 , Vírgula na posição especificada 999,999 1,234 MI Sinais de menos à direita (valores negativos) 999999MI 1234- PR Números negativos entre parênteses 999999PR <1234> EEEE Notação científica (formato deve especificar quatro Es) 99.999EEEE 1.234E+03 V Multiplica por 10n vezes (n=número de 9s depois de V) 9999V99 123400 B Exibe os valores zero como espaços em branco, não como 0. B9999.99 1234.00 Por exemplo, para emitirmos a relação de pedidos realizados no dia 21 de setembro de 1992, com o respectivo total do pedido : SQL> SELECT ID, TO_CHAR(TOTAL, '$9,999,999') TOTAL
2 FROM ORD 3 WHERE DATE_SHIPPED = TO_DATE('21/09/1992');
ID TOTAL
-----------
107 $142,171 110 $1,539 111 $2,770
Definindo consultas SQL Através de Relacionamentos Equijoin, Outerjoin e Self-Join Um banco de dados PostGreSQL contém dezenas ou centenas de tabelas. O fato importante é que nenhum banco de dados contém somente uma tabela para armazenar todos os dados do banco. As tabelas de um banco de dados são projetadas a partir de um modelo que expressa a sua estrutura e a inter-relação entre estas. Quando o usuário necessita selecionar dados em mais de uma tabela, é necessário realizar uma operação join (ou junção). Um join de tabela ocorre quando os dados de uma tabela são associados aos dados de uma outra tabela de acordo com uma coluna comum às duas tabelas. Existem dois tipos principais de condições de join: Equijoins Não-equijoins Os métodos adicionais incluem : Outer joins Self joins Operadores de Conjunto Quando as condições de join forem inválidas ou omitidas, o resultado de uma consulta é um produto cartesiano. Em um produto cartesiano todas as linhas de uma tabela são unidas a todas as linhas da segunda tabela.
Consulta com um Join Simples Podemos exibir dados a partir de uma ou mais tabelas relacionadas, escrevendo uma condição de join simples na cláusula FROM. A sintaxe para um join simples é : SELECT table.column, table.column... FROM table1 inner join table2
on table1.column1 = table2.column2;
Por exemplo, na tabela EMP somente os números dos departamentos são armazenados, não seus nomes. Para cada funcionário, nós queremos recuperar o nome, o número e o nome do departamento em que trabalha : SQL> SELECT E.LAST_NAME, E.DEPT_ID, D.NAME
2 FROM EMP E, DEPT D 3 WHERE E.DEPT_ID = D.ID;
LAST_NAME DEPT_ID NAME
--------- -------------------------
Velasquez 50 Administration Ngao 41 Operations Nagayama 31 Sales Quick-To-See 10 Finance Ropeburn 50 Administration Urguhart 41 Operations Menchu 42 Operations Biri 43 Operations Catchpole 44 Operations Havel 45 Operations Magee 31 Sales No exemplo anterior, E e D são apelidos para as tabelas EMP e DEPT, respectivamente. A consulta fornecida é processada da seguinte maneira : Cada linha da tabela EMP é combinada com cada linha da tabela DEPT, formando um produto cartesiano. Se EMP contem m linhas e DEPT contém n linhas, o resultado é m*n linhas. A partir do produto cartesiano, são selecionadas as linhas que possuem o mesmo número de departamento (E.DEPT_ID = D.ID) Neste exemplo a condição de join para as duas tabelas é baseada no operador de igualdade "=". Esta operação de join é chamada de equijoin. Mais de duas tabelas também podem ser combinadas em um equijoin. Como exemplo, para cada cliente, recuperar o nome, o nome do representante de vendas e o nome da região em que se encontra :
SQL> SELECT C.NAME, E.LAST_NAME, R.NAME
2 FROM CUSTOMER C 3 inner join EMP E on (C.SALEREP_ID = E.ID) 4 inner join REGION R on (C.REGION_ID = R.ID)
NAME LAST_NAME NAME
-------------------- --------------------
Unisports Giljum South America Simms Athletics Nguyen Asia Delhi Sports Nguyen Asia Womansport Magee North America Kam's Sporting Goods Dumas Asia Sportique Dumas Europe Muench Sports Dumas Europe Como regra geral, para N tabelas combinadas através de join deve existir pelo menos N-1 condições de join, a fim de evitar um produto cartesiano.
Relacionamentos Não-Equijoins Obtemos relacionamentos não-equijoins quando não existe nenhuma correspondência entre as tabelas envolvidas em uma consulta. A relação não-equijoin é obtida usando um operador diferente do operador de igualdade (=). Por exemplo, para avaliar a classificação salarial de um funcionário. O salário deve ficar entre qualquer par das faixas de salário superior e inferior : SQL> SELECT E.LAST_NAME, E.TITLE, E.SALARY, S.GRADE
2 FROM EMP E, SALGRADE S 3 WHERE E.SALARY BETWEEN S.LOSAL AND S.HISAL;
LAST_NAME TITLE SALARY GRADE
------------------------- --------- ---------
Urguhart Warehouse Manager 1200 1 Biri Warehouse Manager 1100 1 Schwartz Stock Clerk 1100 1 Nagayama VP, Sales 1400 2 Menchu Warehouse Manager 1250 2 Maduro Stock Clerk 1400 2 Ngao VP, Operations 1450 3 Quick-To-See VP, Finance 1450 3 Ropeburn VP, Administration 1550 3 Velasquez President 2500 4
Relacionamentos Outer Joins Se uma linha não satisfizer uma condição de join, a linha não aparecerá no resultado da pesquisa. As linhas que faltam podem ser retornadas se for usada uma operação outer join na condição de join. A sintaxe de uma operação outer join é: SELECT table.column, table.column
FROM table1 LEFT OUTER JOIN table2 on (table1.column = table2.column);
ou : SELECT table.column, table.column FROM table1 RIGTH OUTER JOIN table2 on (table1.column = table2.column); Por exemplo, para exibição do nome do representante de vendas, do número do funcionário e do nome do cliente para todos os clientes, mesmo se não houver um representante de vendas para o cliente: SQL> SELECT E.LAST_NAME, E.ID, C.NAME
2 FROM CUSTOMER C LEFT OUTER JOIN EMP E ON (E.ID = C.SALEREP_ID);
LAST_NAME ID NAME
--------- --------------------------
Giljum 12 Unisports Nguyen 14 Simms Athletics Dumas 15 Sportique Sweet Rock Sports Dumas 15 Muench Sports Magee 11 Beisbol Si! Giljum 12 Futbol Sonora Dumas 15 Sporta Russia ...
Relacionamentos Self Joins Você pode fazer um join de uma tabela com ela própria, usando os aliases (apelidos) de tabela para simular a existência de duas tabelas separadas. Isto permite que as linhas em uma tabela sejam unidas às linhas na mesma tabela. Para simular duas tabelas na cláusula FROM, o exemplo a seguir contém um alias para a mesma tabela, EMP. Esse é um exemplo de boa combinação de nomes. Neste exemplo, a cláusula ON contém o join que significa "onde o número do gerente de um funcionário corresponde a um número de funcionário para o gerente". Isto se dá ao fato de que todo gerente também é um funcionário : SQL> SELECT funcionario.last_name || ' trabalha para ' ||
2 gerente.last_name 3 FROM emp funcionário INNER JOIN emp gerente ON funcionario.manager_id = gerente.id ;
FUNCIONARIO.LAST_NAME||'TRABALHAPARA'||GERENTE.LAST_NAME
Ngao trabalha para Velasquez Nagayama trabalha para Velasquez Quick-To-See trabalha para Velasquez Ropeburn trabalha para Velasquez Smith trabalha para Urguhart Nozaki trabalha para Menchu Patel trabalha para Menchu ... Agrupando Dados com SQL Diferente das funções de linhas simples, as funções de grupo operam em conjunto de linhas para dar um resultado por grupo. Esses conjuntos podem ser a tabela inteira ou dividida em grupos. As funções de grupo aparecem tanto nas listas SELECT como nas cláusulas HAVING. Por default, todas as linhas em uma tabela são tratadas como um grupo. A cláusula GROUP BY é utilizada no comando SELECT para dividir as linhas em grupos menores. Além disso, para restringir os grupos resultantes que são retornados, utiliza-se a cláusula HAVING : SELECT column, group_function FROM table [WHERE condition] [GROUP BY group_by_expression] [HAVING group_condition] [ORDER BY column]; onde : group_by_expression ? especifica as colunas cujos valores determinam a base para agrupar linhas. group_condition ? restringe os grupos de linhas retornados, para os grupos cuja condição especificada tenha sido TRUE.
Funções de Grupo AVG(DISTINCT|ALL|n) Calcula o valor médio de n, ignorando valores nulos. Por exemplo, o salário médio entre todos os funcionários : SQL> SELECT AVG(SALARY) FROM EMP; AVG(SALARY)
1255,08 COUNT(DISTINCT|ALL|expr|*) Número de linhas, onde expr avalia valores diferentes de nulo. Conta todas as linhas selecionadas usando *, incluindo duplicadas e linhas com valores nulos. Por exemplo, para calcular a quantidade de funcionários cadastrados : SQL> SELECT COUNT(*) FROM EMP;
COUNT(*)
25 MAX(DISTINCT|ALL|expr) Retorna o valor máximo para a expressão fornecida. Por exemplo, para exibição do maior salário entre os funcionários do departamento 31 : SQL> SELECT MAX(SALARY)
2 FROM EMP 3 WHERE DEPT_ID = 31;
MAX(SALARY)
1400 MIN(DISTINCT|ALL|expr) Retorna o valor mínimo para a expressão fornecida. Por exemplo, para exibição do menor salário entre todos os funcionários : SQL> SELECT MIN(SALARY)
2 FROM EMP;
MIN(SALARY)
750 SUM(DISTINCT|ALL|n) Calcula o somatório de n, ignorando os valores nulos. A função SUM pode ser aplicada somente sobre colunas de tipo NUMERIC. Por exemplo, para exibirmos o total de venda de todos os pedidos : SQL> SELECT TO_CHAR(SUM(TOTAL), '$9,999,999') SALETOTAL
2 FROM ORD;
SALETOTAL
$2,078,492 A palavra DISTINCT faz com que a função de grupo considere somente valores não-duplicados. A palavra ALL faz com que ela considere todos os valores, inclusive os duplicados. O default é ALL, e portanto, não precisa ser especificado. Todas as funções de grupo, exceto COUNT(*), ignoram valores nulos.
A cláusula GROUP BY A cláusula GROUP BY é utilizada para dividir as linhas de uma tabela em grupos menores. Dessa forma, as funções de grupo podem ser usadas para retornar informações resumidas para cada grupo. Se você incluir uma função de grupo em uma cláusula SELECT, não poderá selecionar resultados individuais, a menos que a coluna individual apareça na cláusula GROUP BY. Você receberá uma mensagem de erro se não incluir a lista de colunas. Nesta lista não é possível utilizar a notação posicional ou aliases para as colunas. Por default, as linhas são classificadas em ordem ascendente da lista GROUP BY. A cláusula ORDER BY sobrepõe esta classificação dada por ORDER BY. Por exemplo, para exibirmos a classificação de crédito de cada cliente e o número de clientes em cada categoria de classificação : SQL> SELECT CREDIT_RATING, COUNT(*) "# Cust"
2 FROM CUSTOMER 3 GROUP BY CREDIT_RATING;
CREDIT_RA # Cust
---------
EXCELLENT 9 GOOD 3 POOR 3 Neste exemplo a seguir, vamos exibir os cargos e total dos salários mensais para cada cargo, excluindo os vice-presidentes, e ordenando a lista de acordo com o total dos salários mensais : SQL> SELECT TITLE, SUM(SALARY) PAYROLL
2 FROM EMP 3 WHERE TITLE NOT LIKE 'VP%' 4 GROUP BY TITLE 5 ORDER BY SUM(SALARY);
TITLE PAYROLL
---------
President 2500 Warehouse Manager 6157 Sales Representative 7380 Stock Clerk 9490 Para restringir as linhas de uma tabela, usamos a cláusula WHERE. No entanto, para restringir os grupos em uma consulta com dados agregados usamos a cláusula HAVING para limitar esses grupos. Por exemplo, para exibirmos os códigos de departamentos e a média salarial dos funcionários por departamento, sendo que deverá ser apresentado somente os departamentos com média salarial acima de 2000 : SQL> SELECT DEPT_ID, AVG(SALARY)
2 FROM EMP 3 GROUP BY DEPT_ID 4 HAVING AVG(SALARY) > 2000;
DEPT_ID AVG(SALARY)
-----------
50 2025 Quando mais de uma coluna é especificada na cláusula GROUP BY, temos vários níveis de agrupamento aninhados, isto é, temos grupos dentro de grupos. Por exemplo, para sabermos quantos funcionários por cargo dentro de cada departamento : SQL> SELECT DEPT_ID, TITLE, COUNT(*)
2 FROM EMP 3 GROUP BY DEPT_ID, TITLE;
DEPT_ID TITLE COUNT(*)
------------------------- ---------
10 VP, Finance 1 35 Sales Representative 1 41 Stock Clerk 2 41 VP, Operations 1 41 Warehouse Manager 1 42 Stock Clerk 2 42 Warehouse Manager 1 43 Stock Clerk 2 43 Warehouse Manager 1 Por exemplo, para exibir o número de funcionário de cada departamento dentro de cada cargo: SQL> SELECT TITLE, DEPT_ID, COUNT(*)
2 FROM EMP 3 GROUP BY TITLE, DEPT_ID;
TITLE DEPT_ID COUNT(*)
--------- ---------
... Sales Representative 34 1 Sales Representative 35 1 Stock Clerk 43 2 Stock Clerk 44 1 Stock Clerk 45 2 VP, Administration 50 1 Warehouse Manager 45 1 ...
Construindo subqueries Até agora nós temos somente concentrados em condições de comparações simples usando a cláusula WHERE do comando SELECT. No entanto, pode ser necessário executar uma consulta que retorne um argumento para um condição de comparação em outra consulta. Uma subquery é um comando SELECT inserido em uma cláusula de outro comando SQL. Pode-se desenvolver comandos sofisticados a partir de comandos simples, utilizando subqueries. Elas podem ser muito úteis quando for necessário selecionar linhas a partir de uma tabela com uma condição que dependa de dados na própria tabela. A subquery pode ser colocada em várias cláusulas de comando SQL : Cláusula WHERE Cláusula HAVING Cláusula FROM de um comando SELECT ou DELETE As subqueries podem ser úteis para gravar comandos SELECT que pesquisem valores baseados em um valor condicional desconhecido. Uma subquery pode ser utilizada para encontrar os valores de dados desconhecidos. A sintaxe é : SELECT select_list FROM table WHERE expr operator (SELECT select_list FROM table); onde : operador ? inclui um operador de comparação como >, <, = ou IN. A subquery geralmente é identificada como um comando sub-SELECT, ou SELECT interno. Em geral, ela é executada primeiro e seu resultado é usado para completar a condição de pesquisa para a pesquisa primária ou externa. Uma subquery deve ser sempre colocada entre parênteses, vir após um operador de comparação. A cláusula ORDER BY não deve ser incluída em uma subquery. Reescrevendo a consulta interna dentro da consulta principal temos : SQL> SELECT DEPT_ID, AVG(SALARY)
2 FROM EMP 3 GROUP BY DEPT_ID 4 HAVING AVG(SALARY) > 5 (SELECT AVG(SALARY) 6 FROM EMP 7 WHERE DEPT_ID = 32);
DEPT_ID AVG(SALARY)
-----------
33 1515 50 2025 Como as subqueries são processadas? Um comando SELECT pode ser considerado como um bloco de consulta. Esse exemplo consiste em dois blocos de consulta : a consulta principal e a consulta interna. Exemplo Recuperação do sobrenome e cargo dos funcionários situados no mesmo departamento que Biri. SQL> SELECT LAST_NAME, TITLE
2 FROM EMP 3 WHERE DEPT_ID = 4 (SELECT DEPT_ID 5 FROM EMP 6 WHERE UPPER(LAST_NAME)='BIRI');
LAST_NAME TITLE
-------------------------
Biri Warehouse Manager Newman Stock Clerk Markarian Stock Clerk Temos as seguintes fases na execução do comando : O comando aninhado SELECT ou o bloco de consulta interno é executado primeiro, produzindo o seguinte resultado da pesquisa : 43. SQL> SELECT DEPT_ID
2 FROM EMP 3 WHERE UPPER(LAST_NAME) = 'BIRI';
DEPT_ID
43 Depois, o bloco principal é processado e utiliza o valor retornado pela subquery aninhada para completar sua condição de pesquisa. A consulta principal pareceria da seguinte forma: SQL> SELECT LAST_NAME, TITLE
2 FROM EMP 3 WHERE DEPT_ID = 43;
LAST_NAME TITLE
-------------------------
Biri Warehouse Manager Newman Stock Clerk Markarian Stock Clerk O exemplo acima apresenta uma subquery que retorna apenas uma linha. Quando uma subquery retornam mais de uma linha, deve-se utilizar um operador de conjunto, como por exemplo, o operador IN, ao invés de um operador de única linha. O operador IN e NOT IN espera um ou mais valores. Por exemplo, para apresentarmos a relação de todos os funcionários que fazem parte de departamento financeiro ou de departamentos da região 2 : SQL> SELECT LAST_NAME, FIRST_NAME, TITLE
2 FROM EMP 3 WHERE DEPT_ID IN 4 (SELECT ID 5 FROM DEPT 6 WHERE UPPER(NAME) LIKE '%FINANCE%' 7 OR REGION_ID = 2);
LAST_NAME FIRST_NAME TITLE
--------------------- ----------------------
Quick-To-See Mark VP, Finance Menchu Roberta Warehouse Manager Giljum Henry Sales Representative Nozaki Akira Stock Clerk Patel Vikram Stock Clerk Além de usar subqueries na cláusula WHERE, pode-se usá-las na cláusula HAVING. O PostGreSQL executa a subquery, e os resultados são retornados na cláusula HAVING da consulta principal. Por exemplo, para exibir a relação de todos os departamentos que tenham uma folha de média salarial maior que a do departamento 32. Neste caso é preciso : Definir a média salarial do departamento 32 : SQL> SELECT AVG(SALARY)
2 FROM EMP 3 WHERE DEPT_ID = 32;
AVG(SALARY)
1490 Exibir a relação das médias salariais superiores a do departamento 32, que é $1490 : SQL> SELECT DEPT_ID, AVG(SALARY) 2 FROM EMP 3 GROUP BY DEPT_ID 4 HAVING AVG(SALARY) > 1490; DEPT_ID AVG(SALARY)
-----------
33 1515 50 2025 Manipulando dados com comandos DML Até aqui vimos o poder da linguagem SQL como uma linguagem eficiente na recuperação de dados. Porém, a linguagem SQL também permite que os dados no banco de dados sejam manipulados. DML ou Linguagem de Manipulação de Dados é a parte da linguagem SQL que consiste em comandos de manipulação de dados. Os comandos de manipulação de dados são : INSERT : Adiciona nova(s) linha(s) na tabela UPDATE : Modifica linha(s) existente(s) na tabela DELETE : Remove linha(s) existente(s) na tabela Inserindo Dados O comando INSERT permite adicionar linhas em uma tabela. Observe abaixo sua sintaxe : INSERT INTO table [(column1, column2, ...)]
VALUES (expr1, expr2, ...)
onde : table ? nome da tabela column ? nome da coluna a inserir dados expr ? expressão cujo valor é correspondente para a coluna informada Quando especificamos valores para todos os campos na inserção de uma linha, não é necessário informar a lista de colunas. Por exemplo, descrevemos a seguir a estrutura da tabela de departamentos DEPT : SQL> \d dept;
Name Null? Type
-------- ----
ID NOT NULL NUMERIC(7) NAME NOT NULL VARCHAR(25) REGION_ID NUMERIC(7) Vamos inserir agora na tabela um registro para um novo departamento de Finanças localizado na região 2 : SQL> INSERT INTO DEPT
2 VALUES (11, 'FINANCE', 2);
1 linha criada. Observe que os valores listados obedecem à ordem original da estrutura da tabela. Os valores de dados do tipo caracter são colocados entre apóstrofos. Se informarmos apenas um subconjunto de colunas para uma nova linha e seus valores, devemos relacioná-las no comando INSERT. Por exemplo, vamos adicionar um novo funcionário, associando a este somente uma identificação, seu primeiro e último nome, identificação de usuário, data de admissão, identificação da chefia e do departamento para o qual foi designado : SQL> INSERT INTO EMP (ID, LAST_NAME, FIRST_NAME, USERID,START_DATE,
2 MANAGER_ID, DEPT_ID) 3 VALUES (26, 'Hering', 'Elizabeth', 'ehering', CURRENT_TIMESTAMP, 2, 32);
1 linha criada. Observe no exemplo acima que a lista de valores segue a ordem das colunas especificadas. Verifique também a palavra CURRENT_TIMESTAMP como valor informado para a coluna START_DATE do tipo data. Isto significa que a data e hora atual no banco de dados foram associadas à admissão do funcionário na empresa. Vamos agora verificar se esta linha foi adicionada na tabela :
SQL> SELECT *
2 FROM EMP 3 WHERE ID = 26;
ID LAST_NAME FIRST_NAME USERID START_DA COMMENTS MANAGER_ID
------------ ---------- -------- -------- --------- ----------
TITLE DEPT_ID SALARY COMMISSION_PCT
--------- --------- --------------
26 Hering Elizabeth ehering 10/05/99 2 32 Observe que quando omitimos o nome da coluna no comando INSERT, automaticamente ele insere um valor NULL para aquela coluna. Entretanto, isto pode ser feito de forma explícita, quando especificamos a palavra-chave NULL na lista de valores. Quando estamos associando um valor NULL para uma coluna, devemos observar também se a coluna permite valores nulos. Por exemplo, relacionamos a tabela de clientes CUSTOMER : SQL> \d CUSTOMER Name Null? Type
-------- ----
ID NOT NULL NUMERIC(7) NAME NOT NULL VARCHAR(50) PHONE VARCHAR(25) ADDRESS VARCHAR(400) CITY VARCHAR(30) STATE VARCHAR(20) COUNTRY VARCHAR(30) ZIP_CODE VARCHAR(75) CREDIT_RATING VARCHAR(9) SALEREP_ID NUMERIC(7) REGION_ID NUMERIC(7) COMMENTS VARCHAR(255) Observe que somente as colunas ID e NAME exigem valores, isto é, não permitem NULL. Vamos criar um registro para um cliente, inserindo valores nulos explicitamente com a palavra-chave NULL : SQL> INSERT INTO CUSTOMER
2 VALUES (216, 'Sports on Wheels', NULL, NULL, NULL, NULL, NULL, 3 NULL, 'GOOD', 12, 2, NULL);
1 linha criada. Atualizando dados Para atualizarmos os dados de uma linha ou um conjunto de linhas de uma tabela, utilizamos o comando UPDATE. O comando UPDATE obedece à seguinte sintaxe : UPDATE table SET column1 = expr1 [, column2 = expr2, ..., columnn = exprn] [WHERE condition] onde : tabela ? nome da tabela a ser atualizada column ? nome da coluna a ser atualizada expr ?expressão cujo resultado é o novo valor para a coluna condition ?restringe o conjunto de linhas a serem atualizadas Quando desejamos atualizar somente uma linha da tabela, devemos identificá-la na cláusula WHERE. Por exemplo, para transferirmos o funcionário 2 para o departamento 10 : SQL> UPDATE EMP
2 SET DEPT_ID = 10 3 WHERE ID = 2;
1 linha atualizada. Para transferirmos o funcionário 1 para o departamento 32 e mudar o seu salário para $2550 : SQL> UPDATE EMP
2 SET DEPT_ID = 32, SALARY = 2550 3 WHERE ID = 1;
1 linha atualizada. Vamos agora verficar as atualizações feitas na tabela : SQL> SELECT ID, FIRST_NAME, LAST_NAME, SALARY, DEPT_ID
2 FROM EMP 3 WHERE ID IN (1,2);
ID FIRST_NAME LAST_NAME SALARY DEPT_ID
---------- ------------ --------- ---------
2 LaDoris Ngao 1450 10 1 Carmen Velasquez 2550 32 Para atualizarmos um conjunto de linhas, devemos selecioná-las através da cláusula WHERE. Por exemplo, para associarmos todos os funcionários do departamento 41 ao novo gerente de código 1 faremos : SQL> UPDATE EMP
2 SET MANAGER_ID = 1 3 WHERE DEPT_ID = 41;
3 linhas atualizadas. Observe no exemplo acima que três linhas foram atualizados. Vamos relacionar os funcionários do departamento 41 para verificarmos a alteração : SQL> SELECT ID, LAST_NAME, DEPT_ID, MANAGER_ID
2 FROM EMP 3 WHERE DEPT_ID = 41;
ID LAST_NAME DEPT_ID MANAGER_ID
------------ --------- ----------
6 Urguhart 41 1 16 Maduro 41 1 17 Smith 41 1 Quando omitimos a cláusula WHERE no comando UPDATE, todas as linhas da tabela são atualizadas. Por exemplo, para efetuarmos um aumento de 10% no salário de todos os funcionários : SQL> SELECT ID, LAST_NAME, SALARY
2 FROM EMP;
ID LAST_NAME SALARY
------------ ---------
1 Velasquez 2550 2 Ngao 1450 3 Nagayama 1400 4 Quick-To-See 1450 5 Ropeburn 1550 6 Urguhart 1200
...
SQL> UPDATE EMP
2 SET SALARY = SALARY * 1.1;
26 linhas atualizadas. Vamos verificar agora a atualização das linhas : SQL> SELECT ID, LAST_NAME, SALARY
2 FROM EMP;
ID LAST_NAME SALARY
------------ ---------
1 Velasquez 2805 2 Ngao 1595 3 Nagayama 1540 4 Quick-To-See 1595 5 Ropeburn 1705 6 Urguhart 1320
...
Removendo dados Para removermos uma linha ou um conjunto de linhas de uma tabela, utilizamos o comando DELETE. O comando DELETE obedece à seguinte sintaxe : DELETE FROM table [WHERE condition] onde : table ? nome da tabela condition ? identifica a(s) linha(s) a ser(em) removida(s) da tabela Para excluir uma única linha de uma tabela, devemos identificá-la através da cláusula WHERE. Por exemplo, supomos que o departamento 52 foi extinto. Devemos então removermos todas as informações sobre este departamento : SQL> DELETE FROM DEPT
2 WHERE ID = 52;
1 linha deletada. Vamos agora confirmar a exclusão da linha : SQL> SELECT ID FROM DEPT
2 WHERE ID = 52;
não há linhas selecionadas. Da mesma forma, utilizamos a cláusula WHERE para excluírmos um conjunto de linhas baseadas em um critério de seleção. Por exemplo, para excluírmos todos os funcionários do departamento 50 : SQL> DELETE FROM EMP
2 WHERE DEPT_ID = 50;
2 linhas deletadas. Para confirmarmos a exclusão das linhas : SQL> SELECT *
2 FROM EMP 3 WHERE DEPT_ID = 50;
não há linhas selecionadas. Quando omitimos a cláusula WHERE, todas as linhas da tabela são removidas : SQL> DELETE FROM ITEM;
62 linhas deletadas.
SQL> SELECT * FROM ITEM;
não há linhas selecionadas. Conceito de transação Uma transação é uma unidade lógica de trabalho que contém um ou mais comandos SQL. Uma transação é uma unidade atômica; os efeitos de todos os comandos SQL dentro de uma transação podem ser ou aplicados no banco de dados ou desfeitos. Uma transação se inicia com um comando SQL. Uma transação termina quando as operações realizadas pelo comando SQL são confirmadas ou desfeitas. A confirmação ou commit significa a efetivação das alterações feitas no banco de dados, tornando-as permanentes. Quando as alterações são desfeitas, diz-se que ocorreu um rollback. Uma transação pode terminar de forma explícita com os comandos COMMIT ou ROLLBACK Quando um comando DDL é fornecido, ocorre uma operação COMMIT de forma implícita. Para ilustrar o conceito de uma transação, considere um banco de dados de uma instituição bancária. Quando um cliente transfere dinheiro de uma conta de poupança para uma conta corrente, a transação consiste em três operações separadas : débito do valor da conta de poupança, crédito do valor na conta corrente e registro da transação bancária no log de operações. O PostGreSQL precisa permitir a ocorrência de duas situações. Se todos os três comandos SQL podem ser executados mantendo o balanço entre as contas envolvidas, os efeitos da transação podem ser aplicados ao banco de dados através de um comando COMMIT. Entretanto, se alguma situação ocorrer (tais como insuficiência de fundos, número de conta inválido ou uma falha de hardware) antes da transação se completar, a transação inteira precisa ser desfeita para manter as contas inalteradas. Esta operação é realizada através do comando ROLLBACK. Início da transação UPDATE savingaccounts SET balance = balance ? 500 WHERE account = 3209;
UPDATE checking_accounts SET balance = balance + 500 WHERE account = 3208;
INSERT INTO journal VALUES (journal_seq.NEXTVAL, ?1B?, 3209, 3208, 500); COMMIT; Nenhum dos comandos da transação acima são tratados de forma independente. Ou toda a transação é executada como um todo, ou esta é desfeita quando ocorre algum erro. O comando COMMIT encerra a transação atual efetivando as alterações pendentes no banco de dados. O comando ROLLBACK encerra a transação atual descartando todas as alterações pendentes no banco de dados. Antes de um COMMIT ou ROLLBACK, as operações de manipulação de dados afetam o buffer do banco de dados. O estado anterior dos dados pode ser recuperado aplicando o comando ROLLBACK. Outros usuários do banco de dados não podem visualizar ou modificar os dados manipulados enquanto a transação não se encerrar com qualquer um dos comandos. Depois de um COMMIT, os dados alterados são gravados nos arquivos do banco, ou seja, o estado anterior das informações é perdido. Além disso, outros do usuários do banco podem visualizar ou modificar os dados que foram alterados. Por exemplo, vamos criar uma nova região de vendas : SQL> SELECT * FROM REGION;
ID NAME
--------------------------------------------------
1 North America 2 South America 3 Africa / Middle East 4 Asia 5 Europe
SQL> INSERT INTO REGION
2 VALUES (6, 'Pacific Ocean');
1 linha criada. Para desfazermos a alteração, fornecemos o comando ROLLBACK : SQL> ROLLBACK;
Rollback completo. Vamos verificar novamente a tabela para confirmar a operação de rollback : SQL> SELECT * FROM REGION;
ID NAME
--------------------------------------------------
1 North America 2 South America 3 Africa / Middle East 4 Asia 5 Europe Para testarmos o comando COMMIT, vamos efetuar um comando UPDATE em uma linha da tabela : SQL> UPDATE REGION
2 SET NAME = 'Africa/Balcans' 3 WHERE ID = 4;
1 linha atualizada. SQL> SELECT * FROM REGION;
ID NAME
--------------------------------------------------
1 North America 2 South America 3 Africa / Middle East 4 Africa/Balcans 5 Europe
SQL> COMMIT;
Validação completa.
Criando Tabelas Uma tabela é criada no banco de dados PostGreSQL através do comando CREATE TABLE. Este comando é um dos comandos da linguagem de definição de dados (DDL). Os comandos DDL são um subconjunto de comandos SQL usados para criar, alterar ou remover estruturas do banco de dados PostGreSQL. Estes comandos tem efeito imediato no banco de dados e também registrar informações no dicionário de dados. Para criar uma tabela, um usuário deve ter o privilégio CREATE TABLE e uma área de armazenamento onde criar os objetos. O administrador de banco de dados usa comandos da linguagem de controle de dados (DCL), para conceder privilégios aos usuários que você tomará. A sintaxe do comando CREATE TABLE é : CREATE TABLE [schema.]table_name (column datatype [DEFAULT expr] [ column_constraint],
...
[table_constraint]) onde : schema ? o nome do proprietário da tabela table ? nome da tabela DEFAULT expr - especifica um valor default para a coluna se um valor for omitido no comando INSERT column ? nome da coluna datatype ? tipo de dados e o tamanho da coluna column_constraint ? restrição de integridade para a coluna table_constraint ? restrição de integridade para a tabela O que é um esquema? Um esquema é uma coleção de objetos. Os objetos do esquema são estruturas lógicas que se referem diretamente aos dados no banco de dados. Os objetos do esquema são tabelas, visões (views), sinônimos, sequences, procedimentos armazenados, índices, clusters e links de banco de dados. As tabelas mencionadas em uma constraint, tais como constraint de chave estrangeira, devem existir no mesmo banco de dados. Se a tabela não pertence ao usuário que está criando a constraint, deve-se especificar o nome do esquema no qual a tabela pertence. A coluna pode receber um valor default usando-se a opção DEFAULT. Esta opção evita que valores nulos sejam inseridos nas colunas se uma linha for intruduzida sem um valor para a coluna. O valor default pode ser um literal, uma expressão ou uma função SQL, como CURRENT_TIMESTAMP e USER, mas o valor não pode ser o nome de outra coluna ou outra pseudocoluna, como NEXTVAL e CURRVAL. A expressão default deve corresponder ao tipo de dados da coluna. Regras de nomeação Para associar um nome a uma tabela ou coluna, é necessário obedecer às seguintes regras : Os nomes de tabelas ou de colunas devem ter de 1 até no máximo 30 caracteres. O primeiro caracter precisa ser alfabético. Os nomes podem conter somente os caracteres A-Z, a-z, 0-9, _, $ e #. Não podem ser escolhidas como nome de tabela ou coluna palavras reservadas do PostGreSQL. Um nome de tabela não pode ser o nome de outro objeto apropriado pelo mesmo usuário. Utilize nomes descritivos para tabelas e colunas Tipos de Dados Há muitos tipo diferentes de colunas. O PostGreSQL pode tratar valores de um tipo de dados diferentemente dos valores de outros tipos de dados. Os tipos básicos de dados são caracter, número, data e RAW. Vejamos os tipos de dados aceitos pelo PostGreSQL : Tipo de Dados Descrição VARCHAR(n) Valores de caracteres de tamanho variáveis até o tamanho máximo n especificado. O tamanho mínimo é 1 e o máximo 4000. CHAR(n) Valores de caracteres de tamanho n fixo. O tamanho default é 1 e o máximo é 255. NUMERIC Número de ponto flutuante com precisão de 38 dígitos significativos. NUMERIC(p,s) Valor númerico com precisão máxima de p, numa faixa de 1 a 38 dígitos e escala máxima de s; a precisão é o número total de dígitos decimais e a escala é o número de dígitos à direita do ponto decimal. DATE Valores de data e hora entre 01 de janeiro de 4712 A.C. e 31 de dezembro de 4712 D.C. TEXT Valores de caracteres de tamanho variáveis de até 2 gigabytes. Só uma coluna LONG é permitida por tabela
A largura da coluna determina o número máximo de caracteres para valores na coluna. O tamanho para as colunas do tipo VARCHAR deve ser especificado. Mesmo se você não especificar o tamanho para as colunas NUMERIC e CHAR, o PostGreSQL associa tamanhos default para estes tipos (38 para tipo NUMERIC e 1 para tipo CHAR). Criando uma tabela a partir de uma Consulta Um outro método para criação de tabela é aplicar a cláusula AS subconsulta para criar a tabela e inserir valores retornados da subconsulta, de acordo com a seguinte sintaxe : CREATE TABLE table [( column [, column...])] AS subquery; onde : table ? nome da tabela column ? é o nome da coluna, valor default e constraint de integridade subquery ? é o comando SELECT que define o conjunto de linhas a ser inserido na nova tabela Apenas a constraint NOT NULL é copiada para a nova tabela. Por exemplo, para construir uma tabela de funcionários lotados no departamento 41 : SQL> CREATE TABLE emp_41
2 AS 3 SELECT id, last_name, userid, start_date 4 FROM emp 5 WHERE dept_id = 41;
Para confirmar a criação da tabela acima : SQL> \d EMP_41
Name Null? Type
-------- ----
ID NOT NULL NUMERIC(7) LAST_NAME NOT NULL VARCHAR(25) USERID NOT NULL VARCHAR(8) START_DATE DATE Definindo Restrições (Constraints) Todas as constraints são armazenadas no dicionário de dados. ÿ fácil referenciá-las se você der um nome significativo. Seus nomes devem seguir a regra de nomeação padrão de objetos. Se você não nomear uma constraint, o PostGreSQL gera um nome com o formato SYCn, onde n é um número inteiro para criar um nome único. Criando Constraints As constraints geralmente são criadas junto com as tabelas. Elas podem ser adicionadas à tabela após sua criação e também desativadas temporariamente. As constraints podem ser definidas usando um dos dois tipos abaixo : Constraints de coluna : Faz referência a uma única coluna e é definida dentro da especificação da coluna. Pode definir qualquer tipo de constraint de integridade. Constraint de tabela : Faz referência a uma ou mais colunas e é definida separadamente das definições das colunas na tabela. Pode definir quaisquer constraints, exceto NOT NULL. Constraint NOT NULL A constraint NOT NULL assegura que valores nulos não sejam permitidos na coluna. Colunas sem a constraint NOT NULL podem conter valores NULL por default. Essa constraint somente pode ser especificada somente a nível de coluna. CREATE TABLE customer...
phone VARCHAR(15) NOT NULL, ... Como a constraint acima não tem nome, o PostGreSQL define automaticamente um nome para ela. Para definirmos um nome usamos a palavra CONSTRAINT, como no seguinte exemplo : CREATE TABLE customer...
last_name VARCHAR(25) CONSTRAINT customer_last_name_nn NOT NULL, ... Constraint UNIQUE Uma constraint UNIQUE designa uma coluna ou combinação de colunas como uma chave única. Duas linhas da tabela não podem ter o mesmo valor para essa chave. Valores nulos são permitidos se a chave única for baseada em uma só coluna. Constraints únicas podem ser definidas no nível de coluna ou tabela. Uma chave única composta é criada usando-se a definição no nível de tabela. Um índice UNIQUE é criado automaticamente para uma coluna de chave única. Por exemplo :
CREATE TABLE customer...
phone VARCHAR(15)
CONSTRAINT customer_phone_uk UNIQUE, ... Constraint PRIMARY KEY Uma constraint PRIMARY KEY cria uma chave primária para uma tabela. Apenas uma chave primária pode ser criada para cada tabela. Uma constraint PRIMARY KEY é uma coluna ou conjunto de colunas que identifica com exclusividade cada linha em uma tabela. Essa constraint força a unicidade da coluna ou combinação de colunas e garante que nenhuma coluna que faça parte da chave primária contenha um valor nulo. Constraints PRIMARY KEY podem ser definidas no nível da coluna ou da tabela. Uma PRIMARY KEY composta é criada usando-se a definição no nível da tabela. Um índice UNIQUE é criado automaticamente para uma coluna PRIMARY KEY. Por exemplo, para criar uma chave primária na tabela de funcionários : ...id NUMERIC(7)
CONSTRAINT emp_id_pk PRIMARY KEY, ... Contraint FOREIGN KEY A constraint FOREIGN KEY, ou constraint de integridade referencial, designa uma coluna ou combinação de colunas como uma chave estrangeira e estabelece um relacionamento com uma chave primária ou uma chave única na mesma tabela ou em outra tabela. Um valor de chave estrangeira deve corresponder a um valor existente na tabela-pai ou ser NULL. Constraints FOREIGN KEY podem ser definidas no nível da coluna ou da tabela. Uma chave estrangeira composta é criada usando-se a definição no nível da tabela. A chave estrangeira é definida na tabela-filho e a tabela que contém a coluna a qual se faz referência é a tabela-pai. Essa chave é definida usando-se a combinação das seguintes palavras-chave : FOREIGN KEY é usada para definir a coluna na tabela-filho no nível da tabela. REFERENCES identifica a tabela e a(s) coluna(s) da chave primária na tabela-pai. ON DELETE CASCADE indica que quando a linha na tabela-pai é excluída, as linhas dependentes da tabela-filho serão também excluídas. Sem a opção ON DELETE CASCADE, a linha na tabela-pai não pode ser excluída se há uma linha na tabela-filho que faz referência a ela. Por exemplo, para definirmos uma chave estrangeira para a coluna DEPT_ID na tabela de funcionários : ...dept_id NUMERIC(7)
CONSTRAINT emp_dept_id_fk REFERENCES dept(id), ... Constraint CHECK A constraint CHECK define uma condição que cada linha deve cumprir. A condição pode usar as mesmas construções que as condições de consultas, com as seguintes exceções : Referências às pseudocolunas CURRVAL, NEXTVAL, LEVEL ou ROWNUM. Chamadas as funções CURRENT_TIMESTAMP, UID, USER ou USERENV. Consultas que fazem referências a outros valores em outras linhas. Constraints CHECK podem ser definidas no nível de coluna ou de tabela. A sintaxe da constraint pode ser aplicada a qualquer coluna na tabela e não apenas à coluna na qual é definida. Por exemplo, para limitarmos o percentual de comissão em uma faixa de valores possíveis : ...comission_pct NUMERIC(4,2) CONSTRAINT emp_comission_pct CHECK (comission_pct IN (10,12.5,15,17.5,20)), ... Vamos listar agora o comando CREATE TABLE para a criação da tabela de funcionários : CREATE TABLE FUNCIONARIO
 (NRO  integer,
  NOME varchar(30)               CONSTRAINT NN\_FUNC\_NOME NOT NULL,
  SUPE integer,
  DEPT integer,
  ADMI Date        DEFAULT now() CONSTRAINT NN\_FUNC\_ADMI NOT NULL,
  SEXO char(1)     DEFAULT 'M',
  PRIMARY KEY (NRO),
  CONSTRAINT CK\_FUNC\_SEXO CHECK (SEXO IN ('M','F')),
  CONSTRAINT FK\_FUNC\_DEPT FOREIGN KEY (DEPT) REFERENCES DEPTO (NRO),
  CONSTRAINT FK\_FUNC\_FUNC FOREIGN KEY (SUPE) REFERENCES FUNCIONARIO  (NRO)
 );
Views de Catalog View Descrição all_tables Tabelas que o usuário pode ?ver? all_tab_columns Colunas da tabela all_constraints Constraints all_cons_columns Colulas das constraints user_table Tabelas criadas pelo usuário logado user_tab_columns Colunas de tabelas criadas pelo usuário logado user_constraints Constraints criadas pelo usuário logado user_cons_colunns Colunas das constraints criadas pelo usuário logado all_indexes Índices all_ind_columns Colunas dos índices pg_user Usuários cadastrados pg_views Views pg_start_activity Usuários logados Tabelas do Catalog do postgreSQL Catalog Name Purpose pg_attrdef column default values pg_attribute table columns ("attributes", "fields") pg_class tables, indexes, sequences ("relations") pg_constraint check constraints, unique / primary key constraints, foreign key constraints pg_database databases within this database cluster pg_depend dependencies between database objects pg_description descriptions or comments on database objects pg_group groups of database users pg_index additional index information pg_language languages for writing functions pg_largeobject large objects pg_namespace namespaces (schemas) pg_proc functions and procedures pg_shadow database users pg_trigger triggers pg_type data types
pg_attrdef This catalog stores column default values. The main information about columns is stored in pg_attribute (see below). Only columns that explicitly specify a default value (when the table is created or the column is added) will have an entry here. pg_attrdef Columns Name Type References Description adrelid oid pg_class.oid The table this column belongs to adnum int2 pg_attribute.attnum The number of the column adbin text An internal representation of the column default value adsrc text A human-readable representation of the default value
pg_attribute pg_attribute stores information about table columns. There will be exactly one pg_attribute row for every column in every table in the database. (There will also be attribute entries for indexes and other objects. See pg_class.) The term attribute is equivalent to column and is used for historical reasons. pg_attribute Columns Name Type References Description attrelid oid pg_class.oid The table this column belongs to attname name Column name atttypid oid pg_type.oid The data type of this column attstattarget int4 attstattarget controls the level of detail of statistics accumulated for this column by ANALYZE. A zero value indicates that no statistics should be collected. A negative value says to use the system default statistics target. The exact meaning of positive values is datatype-dependent. For scalar datatypes, attstattarget is both the target number of "most common values" to collect, and the target number of histogram bins to create. attlen int2 This is a copy of pg_type.typlen of this column's type. attnum int2 The number of the column. Ordinary columns are numbered from 1 up. System columns, such as oid, have (arbitrary) negative numbers. attndims int4 Number of dimensions, if the column is an array type; otherwise 0. (Presently, the number of dimensions of an array is not enforced, so any nonzero value effectively means "it's an array".) attcacheoff int4 Always -1 in storage, but when loaded into a tuple descriptor in memory this may be updated to cache the offset of the attribute within the tuple. atttypmod int4 atttypmod records type-specific data supplied at table creation time (for example, the maximum length of a varchar column). It is passed to type-specific input functions and length coercion functions. The value will generally be -1 for types that do not need typmod. attbyval bool A copy of pg_type.typbyval of this column's type attstorage char Normally a copy of pg_type.typstorage of this column's type. For TOASTable datatypes, this can be altered after column creation to control storage policy. attisset bool If true, this attribute is a set. In that case, what is really stored in the attribute is the OID of a tuple in the pg_proc catalog. The pg_proc tuple contains the query string that defines this set - i.e., the query to run to get the set. So the atttypid (see above) refers to the type returned by this query, but the actual length of this attribute is the length (size) of an oid. --- At least this is the theory. All this is probably quite broken these days. attalign char A copy of pg_type.typalign of this column's type attnotnull bool This represents a NOT NULL constraint. It is possible to change this field to enable or disable the constraint. atthasdef bool This column has a default value, in which case there will be a corresponding entry in the pg_attrdef catalog that actually defines the value. attisdropped bool This column has been dropped and is no longer valid. A dropped column is still physically present in the table, but is ignored by the parser and so cannot be accessed via SQL. attislocal bool This column is defined locally in the relation. Note that a column may be locally defined and inherited simultaneously. attinhcount int4 The number of direct ancestors this column has. A column with a nonzero number of ancestors cannot be dropped nor renamed.
pg_constraint This system catalog stores CHECK, PRIMARY KEY, UNIQUE, and FOREIGN KEY constraints on tables. (Column constraints are not treated specially. Every column constraint is equivalent to some table constraint.) See under CREATE TABLE for more information. Note: NOT NULL constraints are represented in the pg_attribute catalog. CHECK constraints on domains are stored here, too. Global ASSERTIONS (a currently-unsupported SQL feature) may someday appear here as well. pg_constraint Columns
Name Type References Description conname name Constraint name (not necessarily unique!) connamespace oid pg_namespace.oid The OID of the namespace that contains this constraint contype char 'c' = check constraint, 'f' = foreign key constraint, 'p' = primary key constraint, 'u' = unique constraint condeferrable boolean Is the constraint deferrable? condeferred boolean Is the constraint deferred by default? conrelid oid pg_class.oid The table this constraint is on; 0 if not a table constraint contypid oid pg_type.oid The domain this constraint is on; 0 if not a domain constraint confrelid oid pg_class.oid If a foreign key, the referenced table; else 0 confupdtype char Foreign key update action code confdeltype char Foreign key deletion action code confmatchtype char Foreign key match type conkey int2[] pg_attribute.attnum If a table constraint, list of columns which the constraint constrains confkey int2[] pg_attribute.attnum If a foreign key, list of the referenced columns conbin text If a check constraint, an internal representation of the expression consrc text If a check constraint, a human-readable representation of the expression
pg_database The pg_database catalog stores information about the available databases. Databases are created with the CREATE DATABASE command. Consult the Administrator's Guide for details about the meaning of some of the parameters. Unlike most system catalogs, pg_database is shared across all databases of a cluster: there is only one copy of pg_database per cluster, not one per database. pg_database Columns Name Type References Description datname name Database name datdba int4 pg_shadow.usesysid Owner of the database, usually the user who created it encoding int4 Character/multibyte encoding for this database datistemplate bool If true then this database can be used in the "TEMPLATE" clause of CREATE DATABASE to create a new database as a clone of this one. datallowconn bool If false then no one can connect to this database. This is used to protect the template0 database from being altered. datlastsysoid oid Last system OID in the database; useful particularly to pg_dump datvacuumxid xid All tuples inserted or deleted by transaction IDs before this one have been marked as known committed or known aborted in this database. This is used to determine when commit-log space can be recycled. datfrozenxid xid All tuples inserted by transaction IDs before this one have been relabeled with a permanent ("frozen") transaction ID in this database. This is useful to check whether a database must be vacuumed soon to avoid transaction ID wraparound problems. datpath text If the database is stored at an alternative location then this records the location. It's either an environment variable name or an absolute path, depending how it was entered. datconfig text[] Session defaults for run-time configuration variables datacl aclitem[] Access permissions
pg_index pg_index contains part of the information about indexes. The rest is mostly in pg_class. pg_index Columns Name Type References Description indexrelid oid pg_class.oid The OID of the pg_class entry for this index indrelid oid pg_class.oid The OID of the pg_class entry for the table this index is for indproc regproc pg_proc.oid The function's OID if this is a functional index, else zero indkey int2vector pg_attribute.attnum This is a vector (array) of up to INDEX_MAX_KEYS values that indicate which table columns this index pertains to. For example a value of 1 3 would mean that the first and the third column make up the index key. For a functional index, these columns are the inputs to the function, and the function's return value is the index key. indclass oidvector pg_opclass.oid For each column in the index key this contains a reference to the "operator class" to use. See pg_opclass for details. indisclustered bool If true, the table was last clustered on this index. indisunique bool If true, this is a unique index. indisprimary bool If true, this index represents the primary key of the table. (indisunique should always be true when this is true.) indreference oid unused indpred text Expression tree (in the form of a nodeToString representation) for partial index predicate. Empty string if not a partial index.
pg_namespace A namespace is the structure underlying SQL92 schemas: each namespace can have a separate collection of relations, types, etc without name conflicts. pg_namespace Columns Name Type References Description nspname name Name of the namespace nspowner int4 pg_shadow.usesysid Owner (creator) of the namespace nspacl aclitem[] Access permissions
pg_trigger This system catalog stores triggers on tables. See under CREATE TRIGGER for more information. pg_trigger Columns Name Type References Description tgrelid oid pg_class.oid The table this trigger is on tgname name Trigger name (must be unique among triggers of same table) tgfoid oid pg_proc.oid The function to be called tgtype int2 Bitmask identifying trigger conditions tgenabled bool True if trigger is enabled (not presently checked everywhere it should be, so disabling a trigger by setting this false does not work reliably) tgisconstraint bool True if trigger implements an RI constraint tgconstrname name RI constraint name tgconstrrelid oid pg_class.oid The table referenced by an RI constraint tgdeferrable bool True if deferrable tginitdeferred bool True if initially deferred tgnargs int2 Number of argument strings passed to trigger function tgattr int2vector Currently unused tgargs bytea Argument strings to pass to trigger, each null-terminated
Compatibilidade Entre Oracle e PostGreSQL Instruções gerais SYSDATE Usar a função agora() NVL COALESCE Tabela DUAL Foi criada no PostGreSQL uma tabela DUAL DECODE CASE a WHEN 1 THEN ?one?
  WHEN 2 THEN ?two?
  ELSE ?other?
END
ou também
CASE WHEN a=1 THEN ?one?
WHEN a=2 THEN ?two?
ELSE ?other?
END
Exemplos práticos:
- DECODE(CAMPO,VALOR1,RESUL1,VALOR2,RESUL2,VALOR_ELSE)
CASE CAMPO WHEN VALOR1 THEN RESUL1
      WHEN VALOR2 THEN RESUL2
      ELSE VALOR\_ELSE
END
- DECODE(CAMPO,NULL,,VALOR)
ERRADO: CASE CAMPO WHEN NULL THEN
ELSE VALOR
END
CORRETOS: CASE WHEN CAMPO IS NULL THEN
ELSE VALOR
END
OU
CASE WHEN CAMPO IS NOT NULL THEN VALOR END Integer/Integer Criei no PG um operador de divisão igual ao Oracle Todas divisão de inteiro/inteiro o PG retorna valor inteiro. Ou seja (10/3) * 3 = 9 Rolução (CAST(10 as Real)/3)*3=10 ROWNUM O PG não tem uma função equivalente ao ROWNUM, por isso precisamos alterar os locais nos fontes ou scripts que usam ROWNUM. 1) Quando o ROWNUM for usado no WHERE para forçar uma SELECT vazia: SELECT COLUNAS FROM ROWNUM = 0 Substituir por um filtro IS NULL em uma coluna NOT NULL com índice. De preferência uma coluna da chave primária. SELECT COLUNAS FROM COLUNA_CHAVE IS NULL 2) Quando o ROWNUM for usado no WHERE para retornar apenas um registro devemos substituí-lo pela função EXISTS: SELECT 1 AS ACHOU
FROM TABELA WHERE NOME LIKE ?A%? AND ROWNUM = 1
Substituir por SELECT 1 AS ACHOU
FROM DUAL WHERE EXISTS (SELECT 0 AS DUMMY FROM TABELA WHERE NOME like ?A%?)
- Quando o ROWNUM for usado para trazer os primeiros registros não há outra solução senão duplicar o código. 4) Quando o ROWNUM for usado dentro do SELECT como uma coluna virtual representando uma unicidade devemos substituí-lo por colunas concatenadas formando uma unicidade. Se não for possível podemos também criar funções randômicas para este fim. 5) Quando o ROWNUM for usado como função analítica para acessar os registros anteriores em um SELECT. Uma solução ainda está sendo analisada para este problema. 6) Quando o ROWNUM for usado para gerar uma determinada ordenação. Uma outra ordenação deve ser estabelecida MINUS Em PG é usada a instrução EXCEPT Joins
No padrão ANSI, compatíveis com os dois bancos os joins de tabelas ficam localizadas sempre na cláusula FROM. O WHERE é usado somente para os filtros.
T1 INNER JOIN T2: Cada linha L1 de T1 é comparada com todas as linhas de T2. Trazendo somente as que satisfazerem a condição de JOIN.
T1 LEFT [OUTER] JOIN T2: Primeiramente, é executado um INNER JOIN. Em seguida, para cada linha em T1 que não satisfaça a condição de união com nenhuma linha em T2, é gerada uma linha adicional com campos nulos nas coluna de T2. A tabela unida sempre possúi uma linha para cada linha em T1.
T1 RIGHT [OUTER] JOIN T2: Primeiro, um INNER JOIN é executado. Em seguida, para cada linha em T2 que não satisfaça a condição de união com nenhuma linha em T1, é gerada uma linha adicional com campos nulos nas colunas de T1. A tabela unida sempre possui uma linha para cada linha em T2
T1 FULL [OUTER] JOIN T2: Primeiro, é executado um INNER JOIN. Em seguida, para cada linha em T1 que não satisfaça a condição de união com nenhuma linha em T2, é gerada uma linha adicional com campos nulos nas colunas em T2. Alem disso, para cada linha em T2 que não satisfaça a condição de união com nenhuma linha em T1, é gerada uma linha adicional com campos nulos nas colunas de T1. A tabela unida sempre possui uma linha para cada linha de T1 e uma linha para cada linha de T2.
As tabelas devem ser dispostas seguindo a ordem de avaliação da query, da esquerda para a direita.
SELECT *
FROM pai,filho WHERE pai.idpai = filho.idpai(+)
SELECT *
FROM pai LEFT JOIN filho ON (pai.idpai=filho.idpai)
POWER Foi criada no PostGreSQL uma função POWER Funções sem parâmetros Função sem parâmetros usar sempre abrir e fechar parênteses no final, ex: now(). InStr Foi criada no PostGreSQL uma função InStr Sub-Selects O PostGreSQL aceita sub-select tanto no FROM como no SELECT. Porém toda sub-select precisa ter um alias. O identificar AS é obrigatório. Concatenações 1) Concatenações quando usadas para comparação devemos separar por parênteses:
CAMPO || CAMPO <> CAMPO || CAMPO Substituir por: (CAMPO || CAMPO) <> (CAMPO || CAMPO)
- No PG qualquer concatenação com NULL resulta em NULL (COALESCE(CAMPO,) || COALESCE(CAMPO,)) <> (COALESCE(CAMPO,) || COALESCE(CAMPO,)) Unknown Field Em um subselect ou em uma view as colunas virtuais formadas por string ou null usar typecast para identificar o tipo:
SELECT errada: SELECT a||'erro' FROM (SELECT 'teste') AS tab
SELECT correta: SELECT a||'erro' FROM (SELECT TO_CHAR('teste') AS tab
Para verificar se alguma view contém uma coluna unknown use:
SELECT DISTINCT TABLE_NAME, COLUMN_NAME, *
FROM ALL_TAB_COLUMNS WHERE TABLE_NAME LIKE capslock('tv%') AND DATA_TYPE LIKE capslock('unknown') AND OWNER LIKE QUALDONO() ORDER BY TABLE_NAME, COLUMN_NAME
Alias de field PG: Exige o identificador ?AS? ?? <> NULL Oracle considera ?? equivalente a NULL, por isso foi criada uma função chamada ISNULL() e ISNOTNULL(). Esta função deve ser usada ao invés de IS NULL ou IS NOT NULL dentro de funções ou em colunas com funções ou expressão dentro de SELECTs, nunca diretamente nas colunas.
Exemplo:
where trim(coluna) is null substituir por where isnull(trim(colunas))
where colunas is null Deve continuar como está // O PG usa o símbolo barra ?/? como código interno. Então para representar uma barra ?/? precisaríamos digitar ?//?
Exemplo: SELECT ?//? FROM DUAL Resultado: PG: ?/?, ORACLE ?//?
Para manter compatibilidade com o Oracle o correto é substituirmos ?/? pelo código CHR(92)
Exemplo: SELECT chr(92) FROM DUAL Resultado: PG: ?/?, ORACLE ?/? TO_NAME No PG o tipo varchar ou char não tem operadores de comparação com o tipo ?name?. Por isso foi criado uma função chamada to_name que no PG retorna como sendo do tipo ?name? Exemplo: SELECT *
FROM ALL_CONSTRAINTS WHERE CONSTRAINT_NAME = TO_NAME(?PK_VEN?)
Sinônimos
search_path